Google душит конкурентов «Аргоном»: тесты Gemini 4 Argon
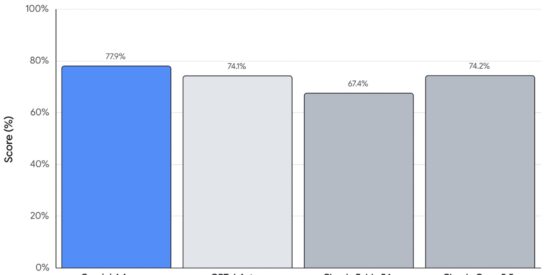
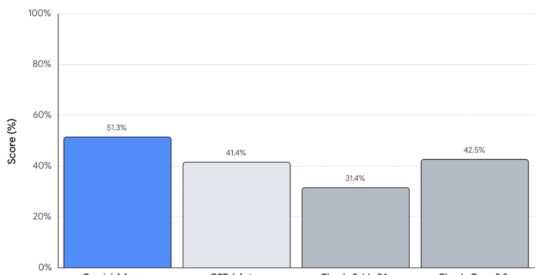
В заявленных Google тестах флагман компании получил:
-
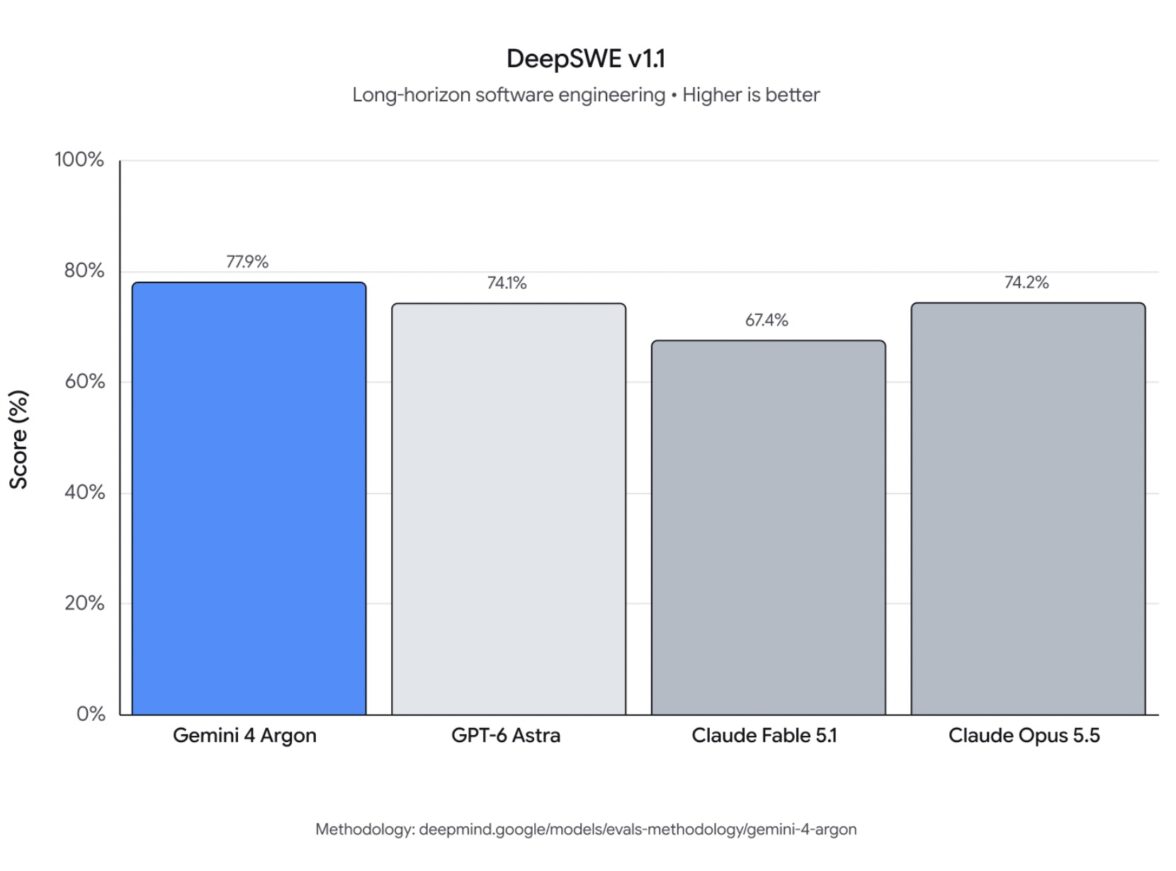
DeepSWE v1.1 (набор тестов на способность автономных ИИ-агентов решать сложные, длительные задачи программной инженерии) — 77,9%. Это лучше, чем у конкурентов GPT-6 Astra (74,1%) и Claude Opus 5.5 (74,2%);
-
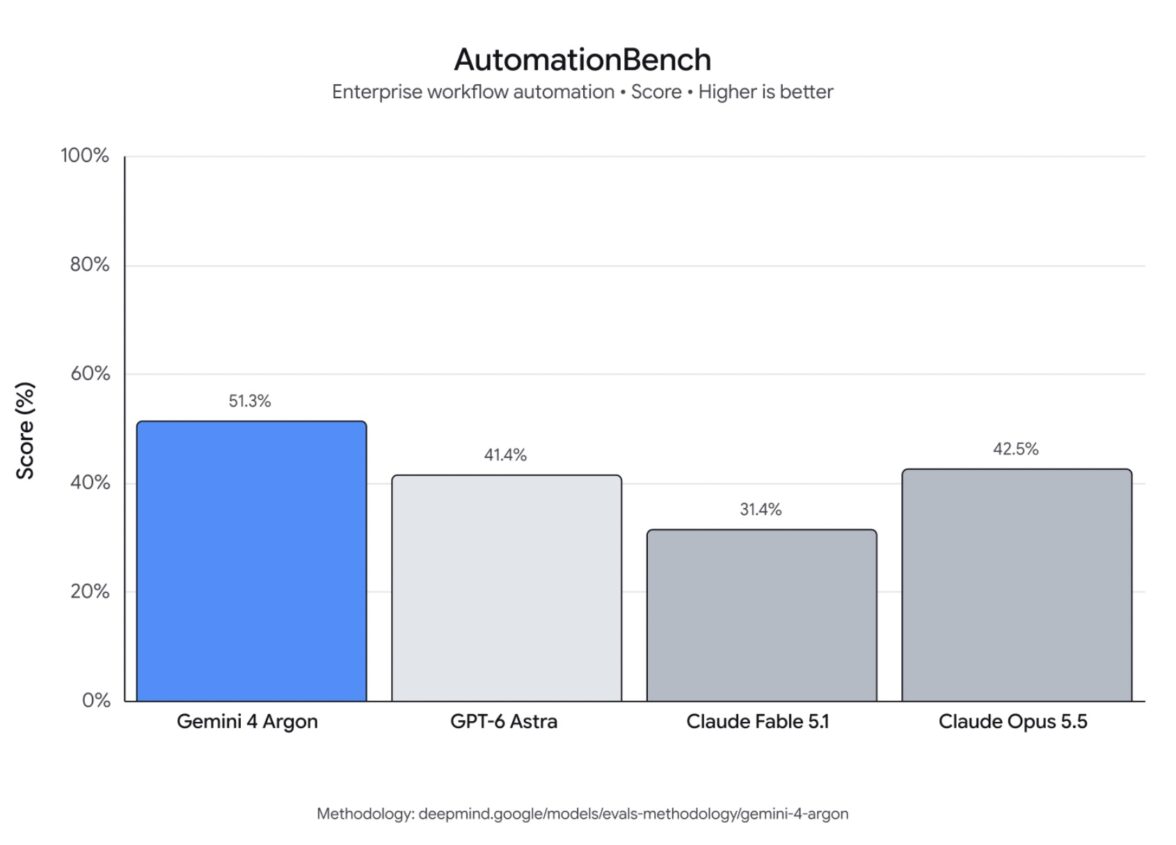
AutomationBench (тесты на способность моделей не просто генерировать текст, а автономно выстраивать цепочки действий через разные сервисы и приложения) — 51,3%. У GPT-6 Astra —41,4%, у Claude Opus 5.5— 40,0%;
-
LVBench (тесты на способность мультимодальных моделей понимать и извлекать информацию из длинных видео) — 91,7%. GPT-6 Astra иClaude Opus 5.5 не тестировались;
-
CWE-bench v1 (серия тестов для оценки способности моделей находить и исправлять уязвимости безопасности в ПО) — 68%. Здесь силы конкурентов практически равны: GPT-6 Astra также получила 68%, а Claude Opus 5.5 — 67%;
-
Vals Index (сводный показатель, оценивающий способность ИИ-моделей решать реальные рабочие задачи в трёх ключевых сферах: финансах, программировании и праве). Gemini 4 Argon — 68,9%, GPT-6 Astra — 63,1%. Claude Opus 5.5 — 66,9%.
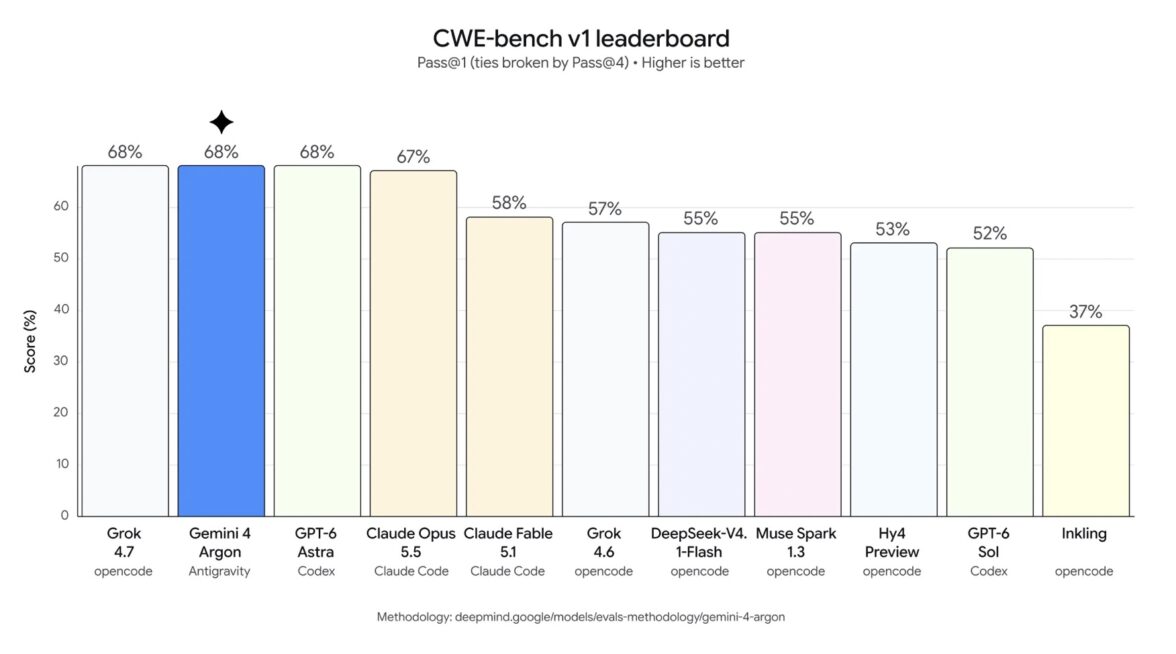
Правда, в альтернативных бенчмарках картина другая:
-
FrontierSWE v2 (похож на DeepSWE v1.1). Gemini Argon — 55%, GPT-6 Astra — 65,5%, Claude Opus 5.5 — 62,3%.
-
Terminal-bench 4.0 (оценивает способность ИИ-агентов решать сложные задачи прямо в командной строке, не просто написать функцию, а довести реальную техническую задачу до конца). Здесь лидирует Claude Opus 5.5 — 66,4%, у Gemini 4 Argon — 57,4%, у GPT-6 Astra — 58,2%.


в Telegram канале

Другие статьи