Anthropic начнет маркировать тексты Claude: как ИИ будет распознавать собственные ответы
Маркировка сгенерированного текста
Еще в начале развития генеративного ИИ активно обсуждалась необходимость маркировать созданный искусственным интеллектом контент. Сегодня эта задача становится практической: Anthropic готовится использовать специальную вотермарку для текстов, сгенерированных Claude. Но как вообще может выглядеть такая маркировка и каким образом ее можно встроить в текст так, чтобы она оставалась незаметной для человека, но распознавалась специальным алгоритмом?
В августе Anthropic объяснила принцип работы своей технологии и причины ее внедрения [1]. Одним из факторов становится регулирование: с 2 августа 2026 года в Европейском союзе вступают в силу требования по маркировке определенных видов контента, созданного с использованием ИИ. В июле Anthropic также присоединилась к соответствующему кодексу вместе примерно со 190 другими подписантами. Таким образом, маркировка постепенно становится не отдельной инициативой, а общим направлением развития индустрии.
При этом маркировать текст значительно сложнее, чем изображения или видео. В визуальном контенте можно незаметно изменить значения отдельных пикселей или встроить дополнительную информацию таким образом, чтобы она практически не влияла на восприятие изображения, но при этом определялась алгоритмом. В тексте такие подходы работают хуже: спецсимволы, двойные тире и прочие «маркеры» легко найти и удалить из текста, убрав все признаки ИИ-генерации.
Именно поэтому исследователи несколько лет искали способы встроить маркировку непосредственно в процесс генерации текста. Так, чтобы она оставалась незаметной для пользователя и при этом не влияла существенно на качество ответа. Чтобы понять, как это возможно, важно разобраться, как работают современные LLM.
LLM: как модель выбирает слова
Упрощенно все происходит так: модель получает запрос и рассчитывает вероятность появления каждого следующего токена. Токеном может быть целое слово, его часть или другой фрагмент текста.
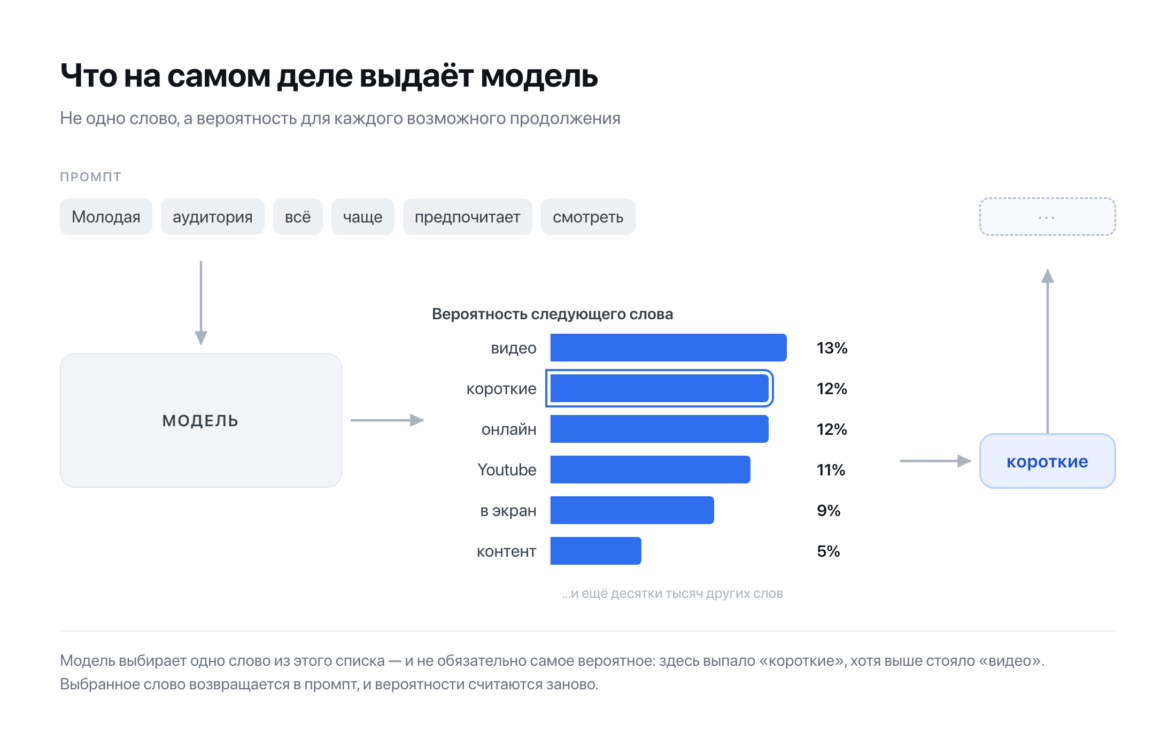
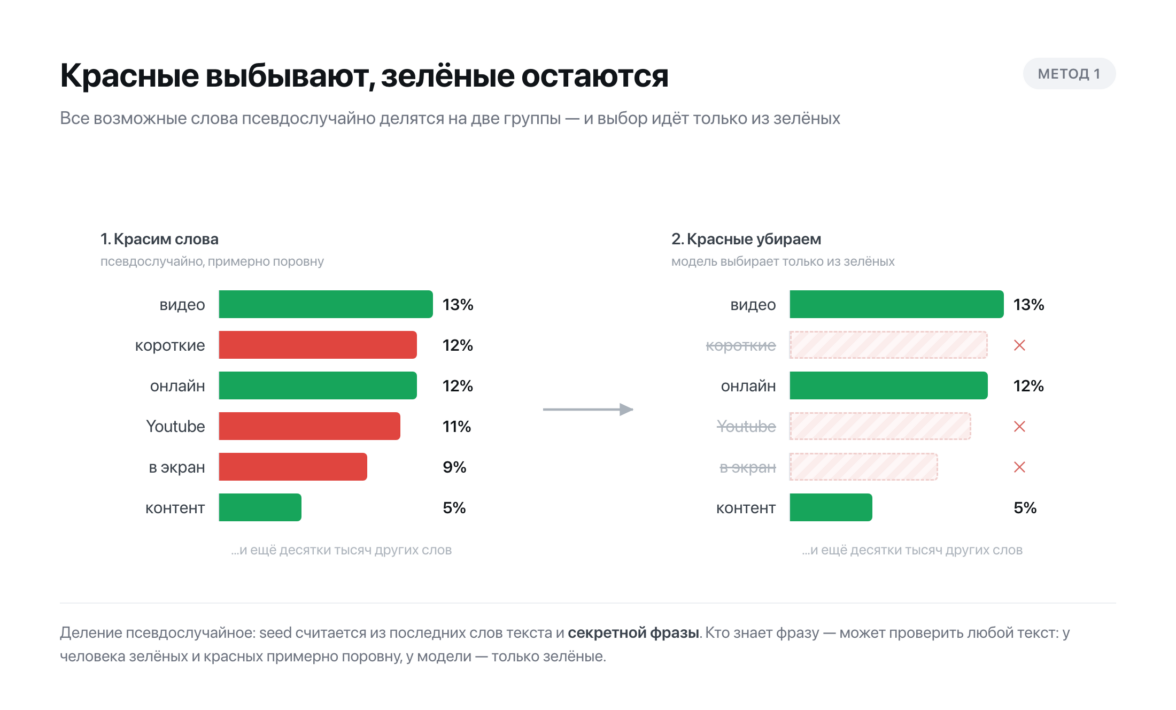
Затем уже, исходя из этих вероятностей, модель и выбирает следующее слово. Например, в конкретном контексте, в 13% случаев она выберет «видео», а в 5% случаев выберет слово «контент».
Дальше модель на основе этих вероятностей выбирает один из вариантов и добавляет его к уже написанному тексту. После этого весь процесс повторяется: модель снова смотрит на получившийся текст и рассчитывает вероятность, какое слово или токен поставить следующим.
«Красные» и «зеленые»: как работает маркировка
Теперь мы можем перейти к тому, как можно «маркировать» текст, созданный ИИ.
Базово все основные методы, которые рассматриваются в статье, работают на последнем шаге работы модели: после определения вероятности появления каждого слова, но до выбора конкретного варианта из этого списка.
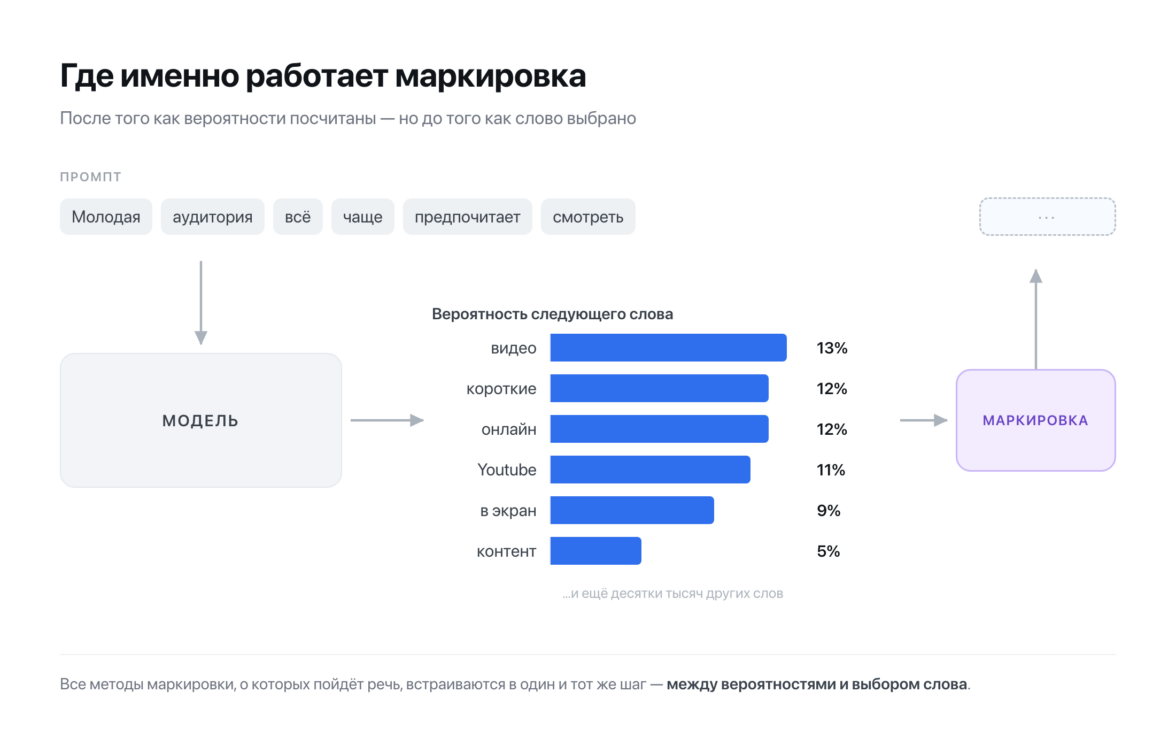
Один из первых предложенных методов маркировки состоит в следующем: все возможные ответы модели делятся условно на две категории – «красные» и «зеленые».
Одни делятся в псевдослучайном порядке. «Псевдослучайный» в данном случае означает, что разделение выглядит случайным и категории зеленых и красных имеют примерно одинаковый размер. Но при создании этого разделения используется определенное число, которое обычно называется seed. При использовании одинакового seed этот метод будет давать абсолютно одинаковое разделение, в отличие от использования действительно случайного метода.
И это очень важно, потому что, зная seed, в дальнейшем можно проверить, к какой группе относится то или иное слово – к «красной» или «зеленой».
В данном методе seed — это число, которое создается на основе нескольких последних слов в промпте и какой-то секретной фразы, например «это написал Claude», с помощью хэш-функции.
После того, как мы «покрасили» возможные слова в зеленый и красный, мы просто исключаем красные из возможных ответов ИИ и оставляем только зеленые, которые выбираются исходя из оригинального распределения вероятностей. В итоге мы получаем текст, который выглядит совершенно нормально: просто где-то модель случайным образом использовала одно слово вместо другого.
Но тот, кто знает seed и секретную фразу, сможет проверить каждое слово текста и определить, к какой категории его должен был отнести алгоритм. Если все слова оказываются «зелеными», это и становится признаком того, что текст был сгенерирован ИИ. Причем не просто «каким-то ИИ», а конкретно тем, который использовал эту секретную фразу при составлении текста. В человеческом же тексте такая проверка покажет примерно одинаковое распределение между «красными» и «зелеными» словами.
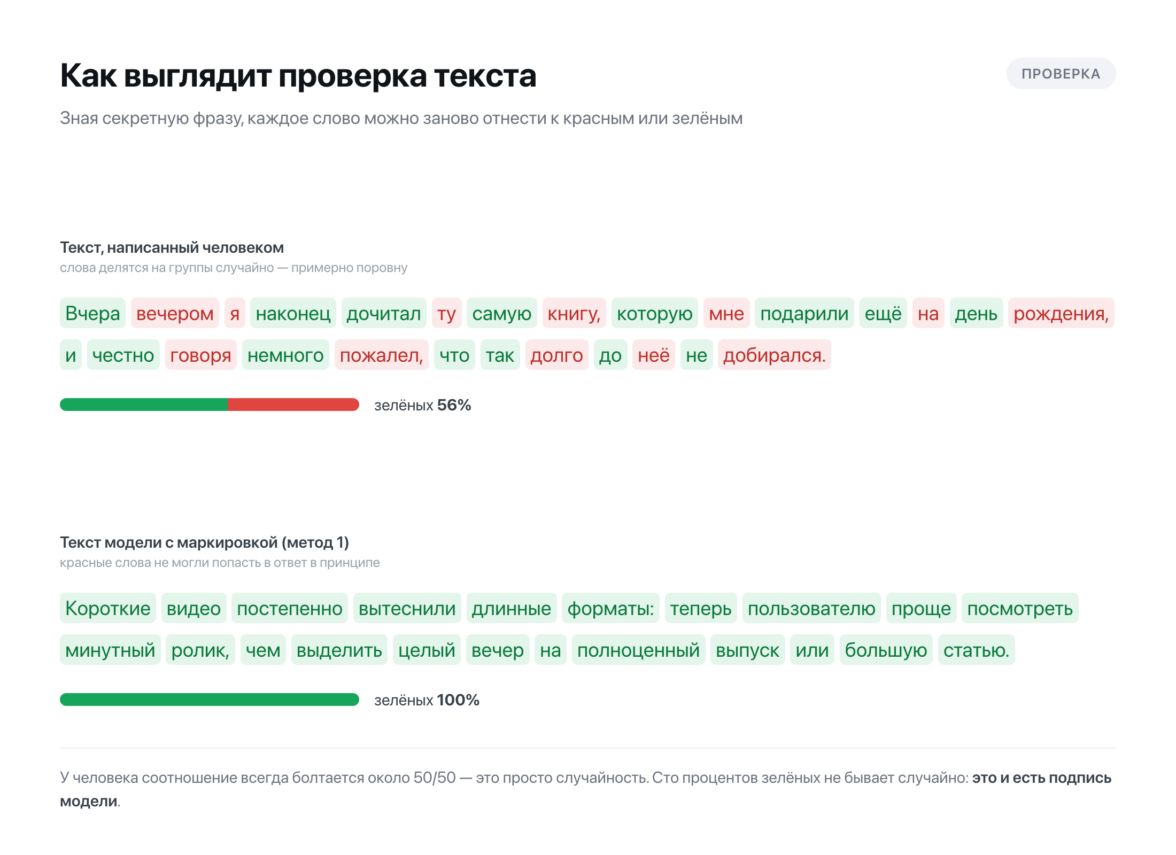
Однако несмотря на то, что этот метод маркировки и верификации может давать 100% точности, у него есть один большой недостаток: в некоторых случаях он может значительно ухудшить качество генерации.
Чтобы понять, почему это происходит, можно рассмотреть такой пример. Допустим, ИИ на вход дается следующая фраза: «Столица Российской Федерации — это город…». Очевидно, что среди всех возможных слов самым вероятным будет «Москва». Для примера, как выглядит реальное распределение вероятностей для одной из моделей:
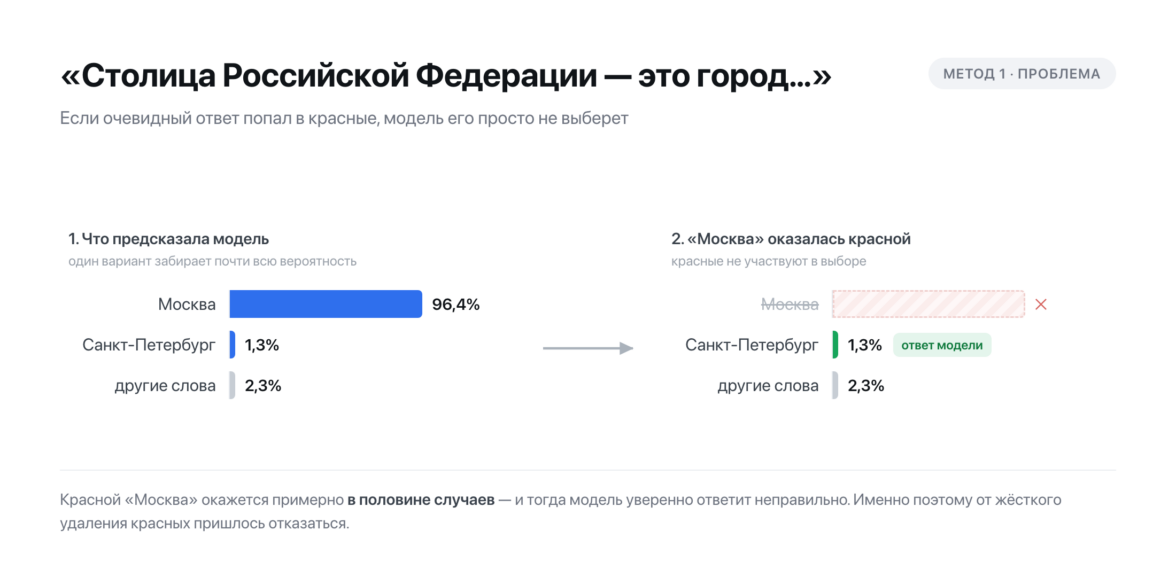
При этом в нашем методе маркировки любой ответ имеет 50% шанс оказаться красным, а красные варианты никогда не попадают в ответ нейросети. А значит, с 50% вероятностью модель даст какой-то другой ответ вместо «Москва». И она будет делать это постоянно.
Как улучшить метод маркировки
Чтобы обойти этот минус, был предложен другой метод. Вместо того чтобы полностью удалять «красные» варианты из выдачи, можно просто увеличить вероятность «зеленых» ответов на какое-то фиксированное значение, например на 5%.
С одной стороны, если есть какой-то один лидирующий вариант ответа с высокой вероятностью, он не пострадает и все равно останется самым вероятным кандидатом на ответ модели. С другой стороны, мы сохраняем возможность отслеживать пропорцию «зеленых» и «красных» слов в итоговом тексте. Если она значимо отличается от 50%, можно сделать вывод, что текст сгенерирован нейросетью.
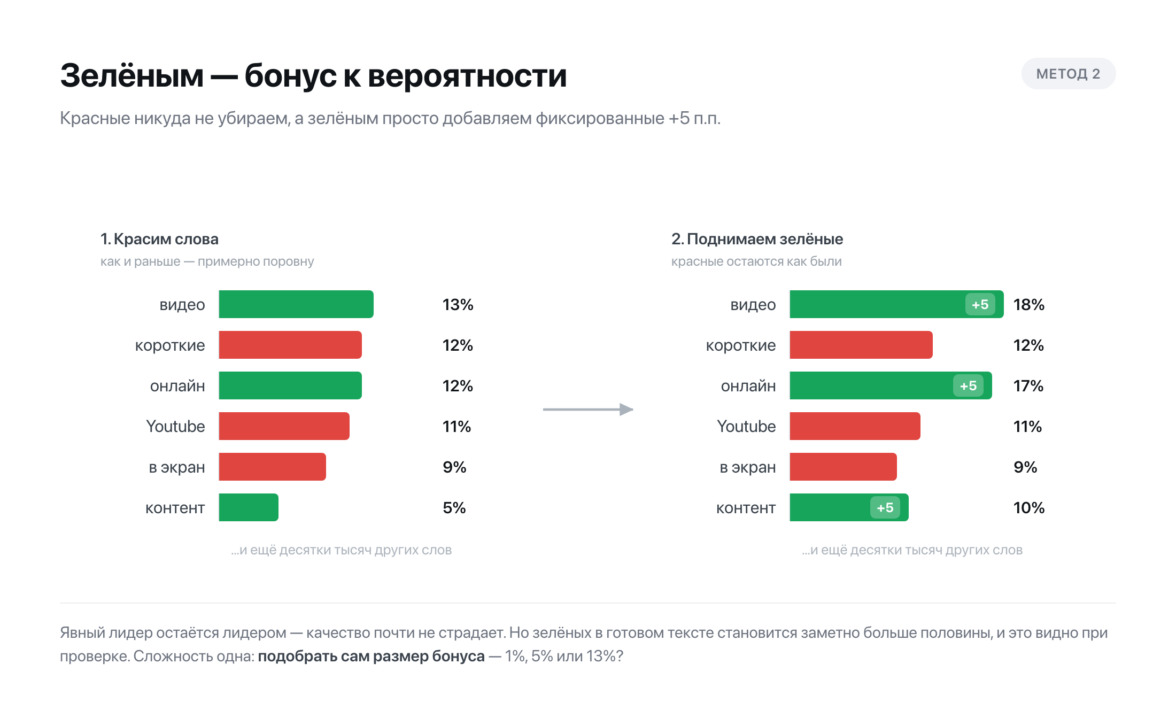
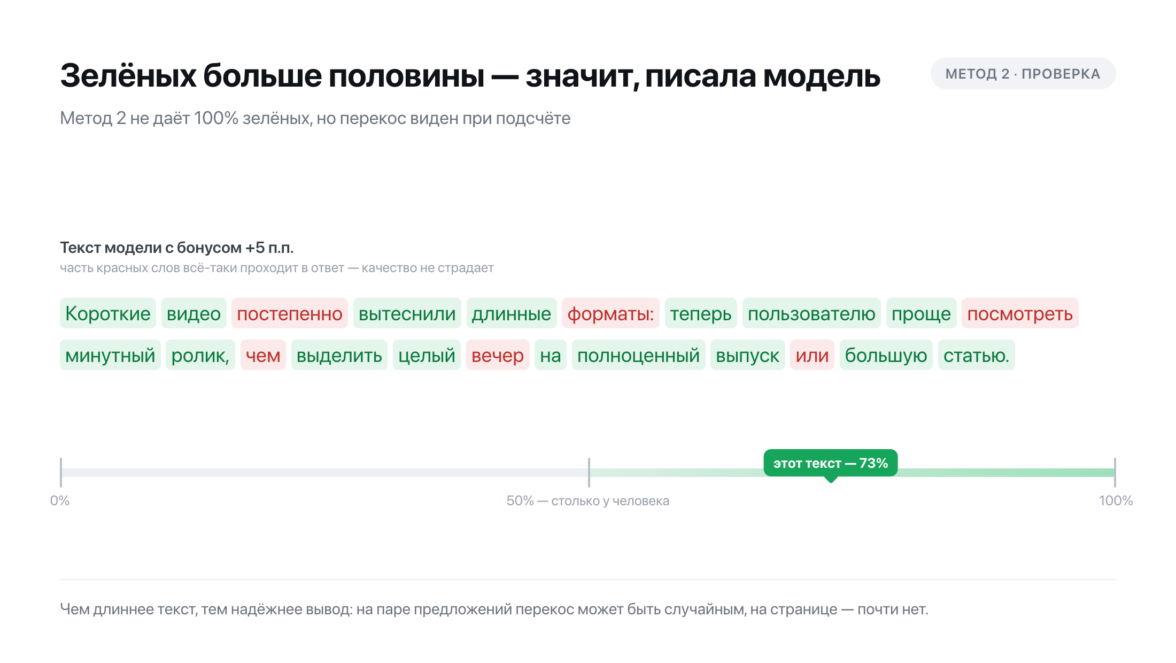
Основная проблема этого метода в сложности правильного подбора параметров. В том числе и тех самых 5% из примера выше. Почему именно 5%? Почему не 1%, 7% или 13%?
Если мы выберем слишком маленькое число, то ответ такой модели будет мало отличаться от ответа модели без маркировки, а итоговое соотношение «красных» и «зеленых» слов будет близко к 50/50.
Если же это число будет слишком большим, то оно также может значимо влиять на качество ответов модели, так как многие «хорошие» варианты ответа будут искусственно получать более низкую вероятность, а ответы модели будут заметно отличаться от того, под что ее изначально тренировали.
А найти правильное число довольно сложно, тем более что оно может отличаться от текста к тексту.
Турнирное сэмплирование
Теперь можно перейти к методу, который будет использовать Anthropic и, скорее всего, другие крупные разработчики.
Отдельно стоит отметить, что метод придумали не в Anthropic. Это метод SynthID-Text от Google DeepMind, опубликованный в Nature в 2024 году [2]. Сама идея восходит к работе Скотта Ааронсона 2022 года. DeepMind также использовали этот метод на части трафика Gemini.
Базовый принцип остается тем же, что и в первом случае: используется псевдослучайная функция, которая берет на вход несколько последних слов промпта и ключевую фразу, а затем делит все варианты ответа модели на «красные» и «зеленые».
А далее используется так называемая турнирная сетка. Выбирается какое-то количество возможных ответов, например 16, исходя из вероятности их появления в ответе. Это важно: варианты с высокой вероятностью, вроде «Москва» в нашем примере выше, имеют высокий шанс попасть в эту сетку.
При этом выбор каждого из 16 ответов не зависит от предыдущего — то есть одно и то же слово может попасть в сетку несколько раз.
А дальше, как на футбольном турнире, проходят «матчи» между вариантами до тех пор, пока не определится победитель. Исход каждого «матча» определяется очень просто: между зеленым и красным словом всегда побеждает зеленое, а если цвета одинаковые, победитель выбирается случайным образом.
Визуализировать это можно вот так:
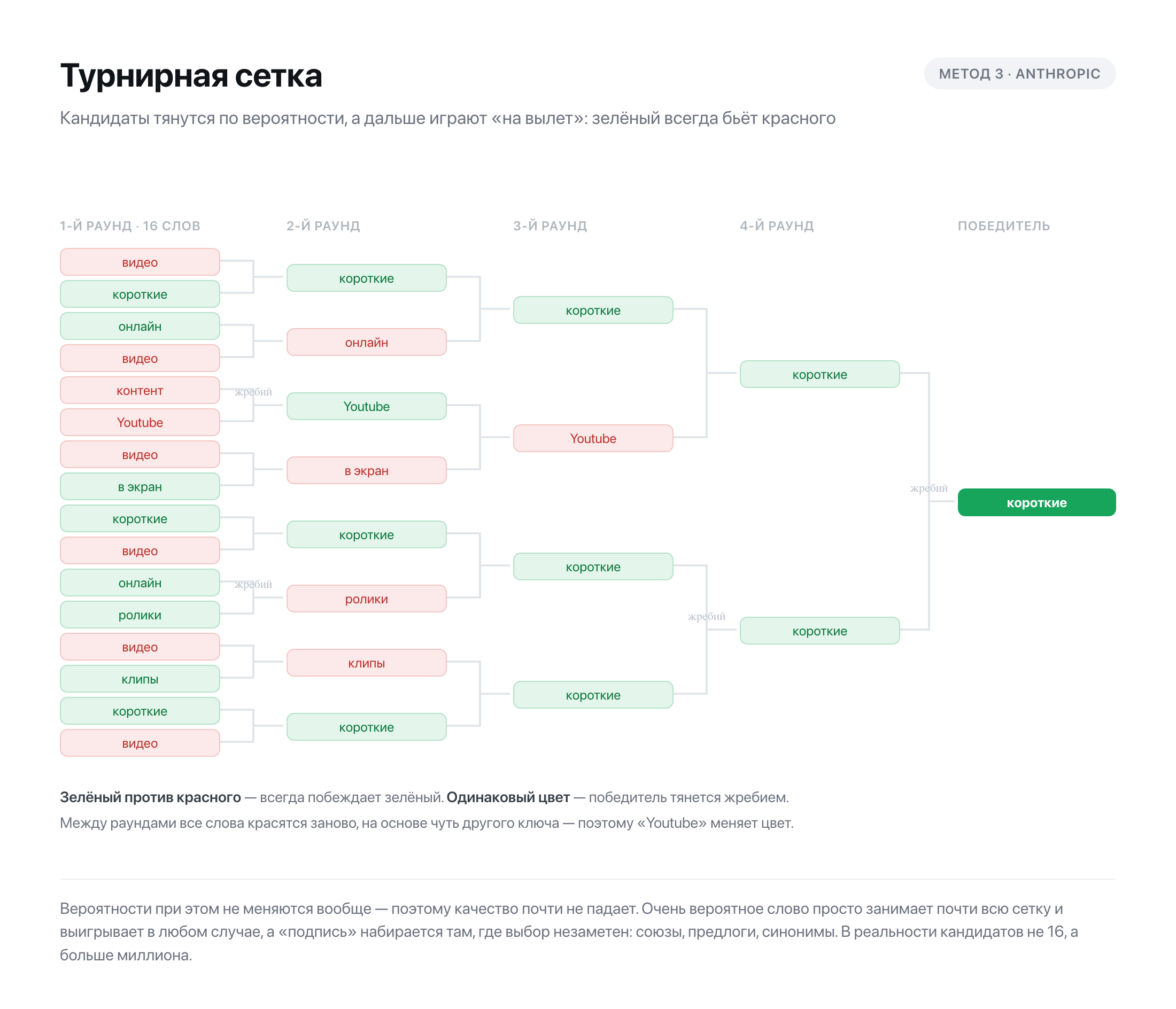
Единственное, в реальности будет выбираться значительно больше кандидатов, речь идет о миллионах возможных вариантов. И на каждом «раунде» все слова заново перекрашиваются в красный и зеленый на основе немного другого ключа.
Весь текст, соответственно, будет состоять из «победителей» нашего турнира. Дальше система верификации ИИ-текста может также провести независимую классификацию каждого слова на зеленое и красное, если знает ключ, и определить, был ли текст написан конкретным ИИ.
У такого метода есть много плюсов:
-
Вероятности, исходя из которых выбирается следующее слово, никак не изменяются, а значит, общий ответ модели будет соответствовать тому, на что ее обучали.
-
Метод работает таким образом, что вся «маркировка», то есть выбор «зеленых» слов вместо «красных» – сосредоточена в тех местах, где этот выбор незаметен: например, при использовании союзов, предлогов, синонимов и т. д. При этом он практически не влияет на слова с очень высокой вероятностью.
-
Это, в свою очередь, приводит к тому, что качество генерации при внедрении маркировки практически не страдает. На тестах разница в качестве составила менее 1% по сравнению с немаркированным текстом.
-
Метод сохраняет значительно большую пропорцию «зеленых» слов в тексте, что позволяет с высокой степенью вероятности определить его как сгенерированный. Человеческий текст будет иметь соотношение, близкое к 50/50.
Несмотря на вышесказанное, метод может плохо работать на небольших текстах с высокой долей «высоковероятных» вариантов продолжения. Но с увеличением объема текста точность распознавания будет расти.
Что нужно знать о проверке текста
На практике у такого подхода есть несколько важных особенностей.
Во-первых, проверка требует доступа к данным самой модели. Чтобы определить, использовалась ли вотермарка, нужно знать seed, на основе которого слова разделяются на «красные» и «зеленые». Эти данные находятся у компании-разработчика, в данном случае Anthropic.
Во-вторых, проверять текст смогут не все. Anthropic уже открыла доступ к инструменту проверки, но пока он предназначен для регуляторов, СМИ, исследователей и компаний, которым такая проверка нужна в рамках их деятельности. Для широкой аудитории такой возможности пока нет.
Ситуация может измениться, если появится единый индустриальный стандарт. Тогда разработчики смогут обмениваться информацией о своих методах маркировки, а проверка текста станет более доступной.
В-третьих, такая маркировка не будет универсальной. Seed у разных моделей и разработчиков будут отличаться. Поэтому один инструмент проверки не сможет определить использование любого ИИ. Для этого потребуется знать методы маркировки разных моделей. Это, опять же, довольно сложно реализовать без какого-то единого органа или стандарта, который аккумулировал бы у себя все эти данные.
Наконец, есть еще один важный вопрос — масштаб использования ИИ. Мир пока не готов узнать, какой процент окружающей нас информации создан с помощью ИИ и какой объем работы на самом деле выполняется с его использованием. Поэтому в ближайшее время инструменты для проверки ИИ-текста, вероятно, не станут общедоступными, даже несмотря на то, что сама маркировка текста по сути уже происходит.
Устойчивость маркировки
Во-первых, по маркировке нельзя будет определить лично пользователя. В самой метке не содержится информации о человеке, компании или конкретном чате.
Во-вторых, код будет маркироваться значительно хуже. Там, где правильный вариант ответа фактически единственный, модели просто не из чего выбирать.
В-третьих, обычная вычитка и легкая редактура не обязательно уберут вотермарку. Она встроена в процесс генерации и связана именно с теми словами, которые выбирает Claude.
Если задача состоит в том, чтобы исходный текст невозможно было связать с конкретной моделью, наиболее надежный способ – существенно переписать его своими словами.
Аналогичный вариант, обработать текст с помощью другой модели и изменить часть формулировок. При дополнительной переработке текста исходная маркировка также может частично или полностью потеряться.
Что это изменит в маркетинге
Для маркетинга распространение маркировки может повлиять прежде всего на производство и проверку контента. ИИ уже используется для подготовки рекламных текстов, постов, описаний и сценариев, поэтому информация о происхождении материала со временем может стать частью стандартного процесса его согласования.
Для брендов и агентств это означает более внимательное отношение к тому, где и как использовался ИИ. При этом сама маркировка не говорит о качестве контента. Важнее будет то, какую роль нейросеть сыграла в создании материала, насколько тщательно его проверили специалисты и кто отвечает за итоговый результат.
Источники:
[1] How Claude’s text watermark worksURL:https://www.anthropic.com/news/claude-text-watermark
[2] Scalable watermarking for identifying large language model outputsURL:https://www.nature.com/articles/s41586-024-08025-4
Другие статьи