Проверка текста на нейросеть: ТОП-3 сервисов для определения ИИ-текста
За последние месяцы я протестировала десяток разных детекторов на своих текстах и текстах коллег, и сегодня расскажу про личный топ из трех сервисов, которым действительно можно доверять хотя бы отчасти. Заодно поделюсь советами, как читать результаты проверки без паники и лишних иллюзий.
 Екатерина СтепановаЭксперт по генеративному ИИ и автоматизации контента
ТОП-3 лучших сайта для проверки текста на ИИ в 2026 году
-
Текст.ру — анализирует частотность повторений и шаблонные обороты, распознает тексты от ChatGPT, DeepSeek, Gemini и Claude, но проверка платная.
-
Текстовод — предлагает бесплатный детектор ИИ и отдельный инструмент Антирерайт, который ищет не совпадения слов, а переписанный смысл.
-
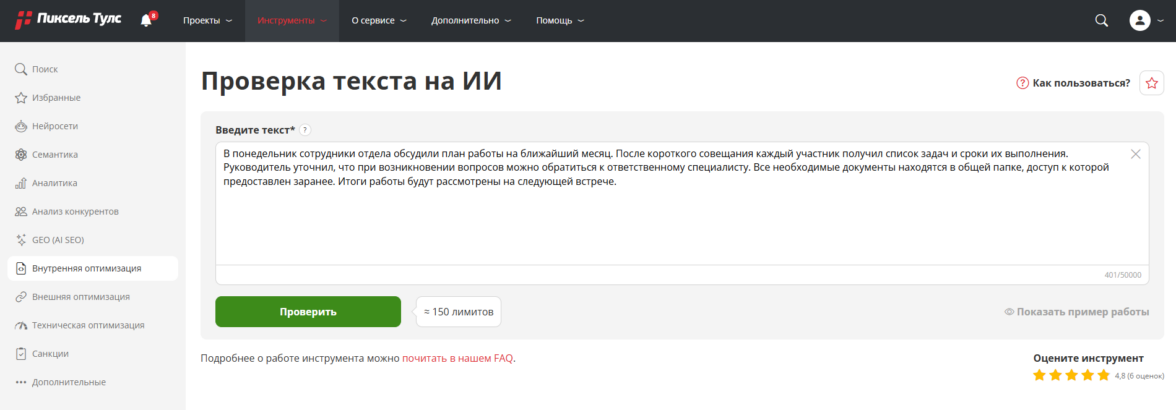
Пиксель Тулс — показывает вероятность генерации от 0 до 100% и подсвечивает конкретные подозрительные фрагменты прямо в тексте.
Каждый копирайтер или редактор рано или поздно сталкивается с необходимостью запустить проверку текста на нейросеть перед публикацией. Я сама прогоняю через детекторы почти каждый текст — не потому что не доверяю себе, а потому что заказчики и поисковики становятся все строже к машинному контенту. Раньше хватало проверки на плагиат, теперь этого мало: клиенты хотят видеть живой, человеческий текст, а не гладкую нейросетевую генерацию без единой шероховатости.
1. Текст.ру
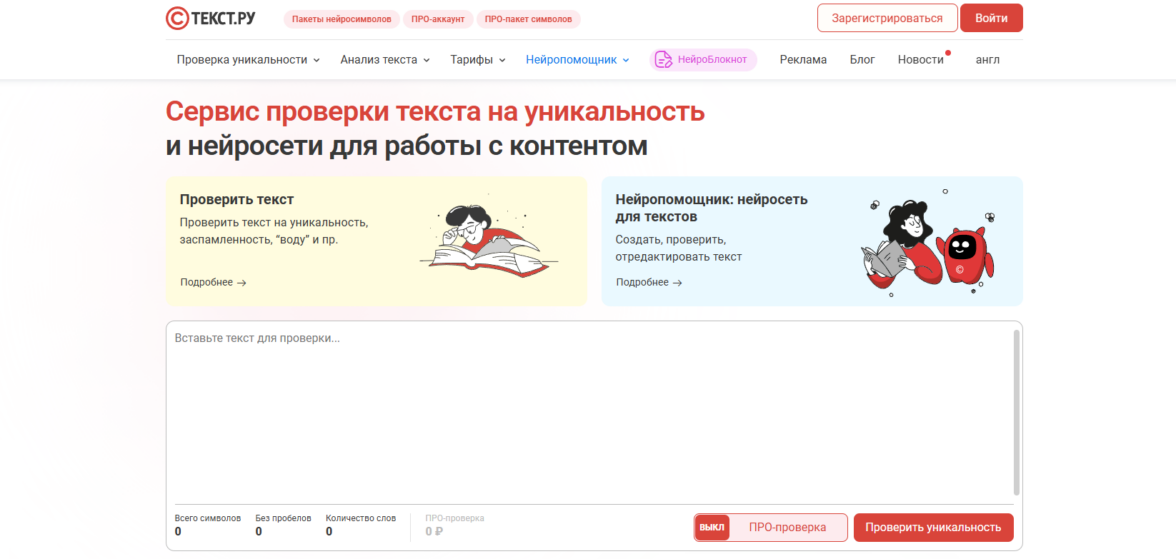
Технически сервис не читает смысл текста, а смотрит на его «поведение»: как часто повторяются слова и фразы, есть ли шаблонные конструкции, которые обычно выдают роботов. Всего за несколько секунд алгоритм выдает процент вероятности того, что перед ним нейросетевой текст, и распознает работы ChatGPT, Gemini, Claude и DeepSeek. С русским языком у сервиса есть слабое место — сама платформа честно предупреждает, что ошибки чаще возникают на канцелярском языке, штампах и однотипных по структуре предложениях. То есть если вы пишете суховатый деловой текст без единого живого оборота, детектор рискует принять его за машинный, даже если писал человек.
-
Доступ без оплаты: отсутствует полностью — сервис прямо говорит, что бесплатной проверки на этой странице нет, оплата идет через нейросимволы
-
Технические рамки: минимум 100 знаков, максимум 50 000 знаков за один прогон
-
Вид отчета: процент вероятности того, что текст написан нейросетью, без разбивки по абзацам
Сильные стороны:
-
распознает сразу несколько популярных моделей — ChatGPT, Gemini, Claude и DeepSeek;
-
результат приходит за несколько секунд;
-
честно объясняет, из-за чего возникают ложные срабатывания, и дает советы, как их избежать.
Слабые стороны:
-
нет бесплатного режима вообще, платить придется за любую проверку;
-
короткие тексты — до 1000 знаков — сервис проверяет менее надежно;
-
канцелярский стиль и однотипные предложения повышают риск ложного вердикта, даже если текст писал человек.
—————————————————————-
—————————————————————-
2. Текстовод
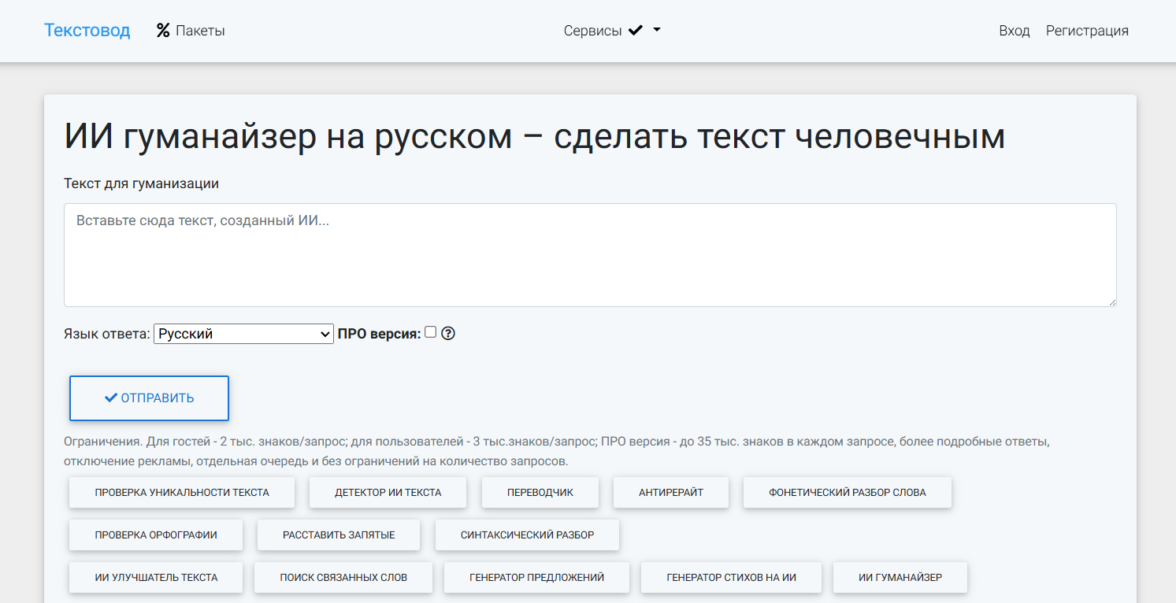
Строит проверку на принципе, который разработчики сами называют «презумпцией невиновности» автора: система старается не обвинять человека в использовании нейросети без веских оснований. Алгоритм распознает не только западные модели — GPT-5, Claude, Gemini и их про-версии, — но и российские YandexGPT с GigaChat, а также китайские генераторы и открытые LLM. На тестовой выборке точность составила 85%, и сервис честно признает возможность отдельных ложных срабатываний. С русским языком инструмент справляется уверенно, так как строился именно под отечественные модели и типичные для рунета обороты речи, а не только под англоязычные тексты.
-
Доступ без оплаты: есть — без регистрации доступно до 10 000 знаков за проверку, с бесплатным аккаунтом лимит растет до 15 000 знаков
-
Технические рамки: в PRO-версии объем одной проверки поднимается до 1 000 000 знаков, а ограничения по количеству запросов снимаются полностью
-
Вид отчета: цветовая подсветка фрагментов — красный цвет означает высокую вероятность ИИ, желтый — подозрительный текст, плюс отдельные проценты явной и подозрительной генерации
Сильные стороны:
-
распознает сразу несколько групп моделей — от GPT-5 и Claude до YandexGPT и открытых LLM;
-
показывает уверенность алгоритма для каждого отдельного фрагмента, а не только общий вердикт;
-
умеет находить гибридные тексты, где вступление писал человек, а основную часть — нейросеть.
Слабые стороны:
-
бесплатный режим ограничен по объему и частоте проверок;
-
заявленная точность в 85% оставляет заметный процент возможных ошибок;
-
детектор не ищет совпадения с опубликованными материалами, поэтому антиплагиат нужно запускать отдельно.
—————————————————————-
—————————————————————-
3. Пиксель Тулс
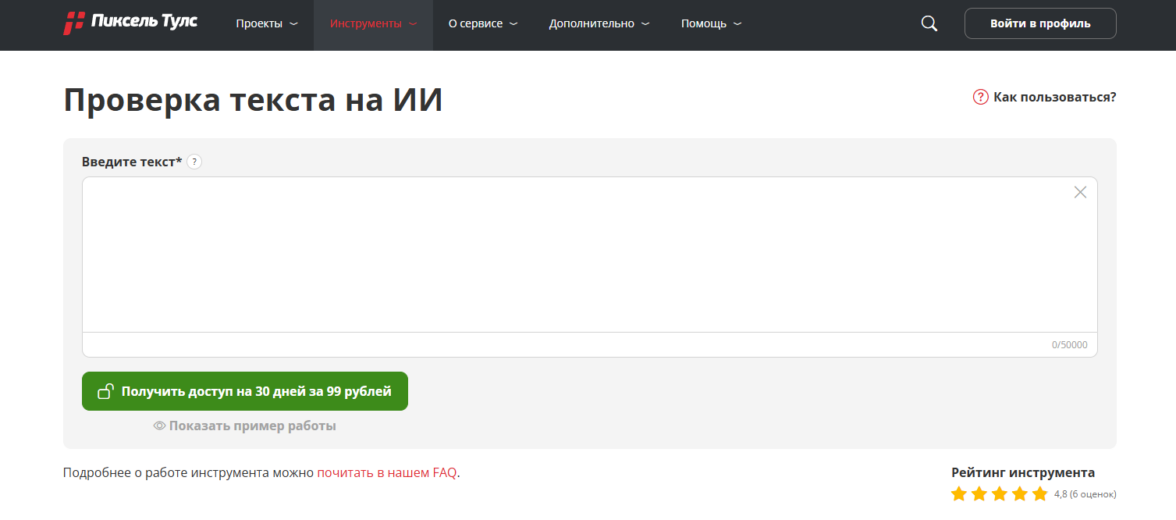
Оценивает лексику, синтаксис и стиль изложения, сопоставляя их с паттернами, характерными для генеративных моделей — так устроена работа алгоритма машинного обучения внутри инструмента . Разработчики прямо пишут, что система обучена находить ChatGPT, Claude, Gemini, LLaMA и другие популярные генераторы, а среднюю точность оценивают в диапазоне 85-95% в зависимости от объема текста и степени его редактуры. Сервис делает та же команда, что стоит за SEO-платформой Пиксель Тулс, — ориентация на русскоязычный контент и работу с сайтами заложена в саму логику продукта, хотя отдельных данных именно про точность на кириллице разработчики не приводят.
-
Доступ без оплаты: открывается после быстрой регистрации, занимающей около минуты, и дает доступ на 30 дней; отдельного бессрочного бесплатного тарифа страница не описывает
-
Технические рамки: конкретный лимит символов на одну проверку в открытых материалах не указан
-
Вид отчета: процент вероятности ИИ-происхождения с подсветкой сгенерированных фрагментов текста
Сильные стороны:
-
распознает сразу несколько популярных моделей — ChatGPT, Claude, Gemini, LLaMA;
-
вместе с результатом дает семь практических советов, как сделать текст более «человеческим»;
-
работает в связке с другими инструментами платформы — проверкой уникальности и генерацией технического задания для копирайтера.
Слабые стороны:
-
полноценный доступ требует регистрации, бессрочного бесплатного режима нет;
-
точность заметно колеблется — от 85 до 95% — в зависимости от объема и качества правки текста;
-
частичное переписывание, по признанию самих разработчиков, способно снизить вероятность обнаружения ИИ.
—————————————————————-
—————————————————————-
Что происходит внутри детектора, когда вы жмете кнопку «Проверить»
AI-детектор работает не как антиплагиат: он не ищет совпадения в интернете, а анализирует сам текст. Алгоритм оценивает лексику, повторы, длину предложений, синтаксис и предсказуемость фраз, затем сравнивает эти признаки с примерами человеческих и сгенерированных материалов. В итоге сервис показывает не автора текста, а вероятность того, что фрагмент похож на генерацию. Например, Turnitin проверяет документ по сегментам, оценивает предложения и формирует общий показатель.
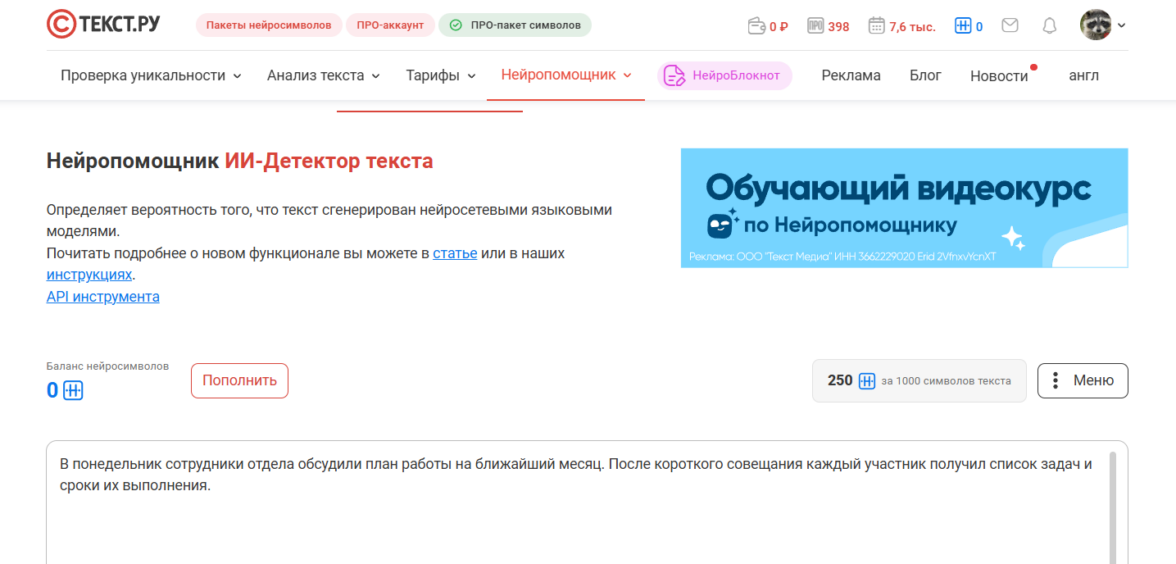
Процент в отчете нельзя считать приговором. Сухой деловой стиль, карточки товаров и академические работы с однотипными конструкциями тоже могут попасть под подозрение. Turnitin предупреждает, что AI-оценка не должна быть единственным основанием для серьезных решений, так как система ошибается и на человеческих текстах, и на материалах после ИИ-редактуры.
Проще говоря, детектор ищет не «автора-робота», а машинный почерк. Поэтому я советую проверять достаточно длинный текст, сравнивать результаты двух сервисов и вручную перечитывать отмеченные фрагменты.
Проверка текста на нейросеть шаг за шагом: инструкция для тех, кто торопится
Если нужно быстро понять, как детектор оценит материал, я действую по простому алгоритму. Он занимает несколько минут и помогает не делать выводов по одной случайной цифре.
-
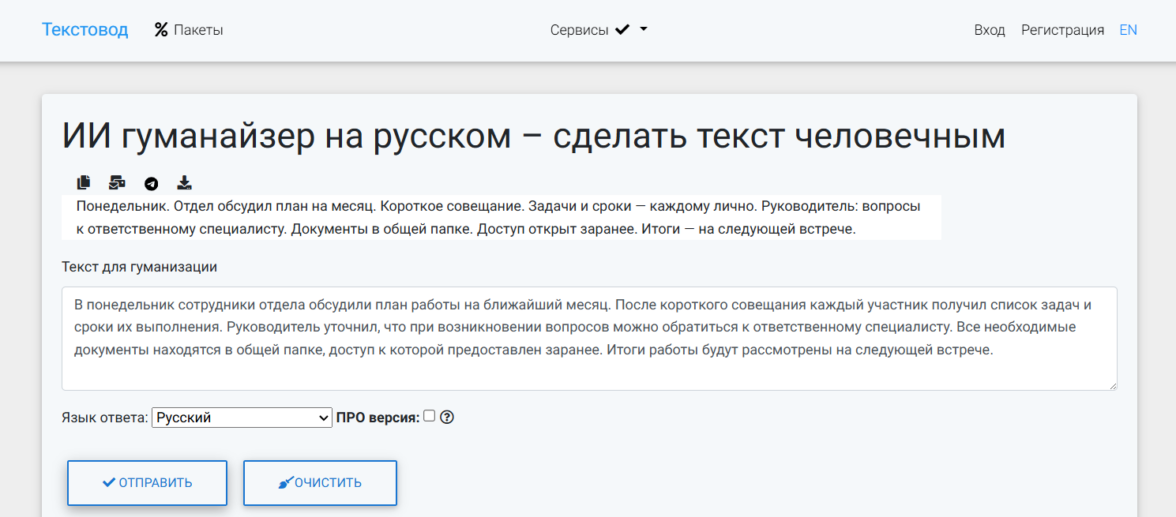
Подготовьте чистый фрагмент текста. Уберите таблицы, списки, ссылки, html-разметку, технические пометки и чужие цитаты. Детектору нужен именно связный текст, иначе структура может исказить итоговую оценку. Для более уверенного результата лучше брать фрагмент от 1000 знаков.
-
Выберите сервис и откройте детектор. Вставьте текст в рабочее поле Text.ru, Текстовода, Пиксель Тулс или другого инструмента. Если сервис просит регистрацию, создайте аккаунт или используйте доступный пробный лимит.
-
Проверьте размер текста. У каждого сайта есть свой максимум символов за один запуск. Если статья длиннее лимита, разделите ее на логические части: вступление, основной блок, выводы. Не режьте один абзац пополам — так результат может стать менее точным.
-
Нажмите кнопку «Проверить» или «Анализировать». Сервис просканирует лексику, повторы, синтаксис и другие языковые паттерны. Обычно отчет появляется за несколько секунд, но длинные тексты могут анализироваться дольше.
-
Смотрите не только на общий процент. Если детектор выделил подозрительные предложения, прочитайте именно их. Чаще всего проверку поднимают однотипные конструкции, слишком ровный ритм, канцелярские обороты и повторяющиеся вводные фразы. Один высокий показатель сам по себе не доказывает использование нейросети.
-
Перепроверьте материал через второй сервис. У разных детекторов свои модели и критерии, поэтому результаты могут расходиться. Я обычно сравниваю два-три отчета, особенно если текст важный: коммерческая статья, учебная работа или материал для клиента.
-
Доработайте фрагменты вручную. Добавьте конкретику, собственные примеры, нормальные переходы между мыслями и живые формулировки. Не пытайтесь просто заменить слова синонимами: такой рерайт часто выглядит еще более механически.
-
Запустите финальную проверку. После правок снова проверьте текст на ИИ и отдельно прогоните его через антиплагиат. Это разные задачи: детектор оценивает признаки генерации, а антиплагиат ищет совпадения с опубликованными материалами.
Что грозит тексту, написанному нейросетью от начала до конца
Сам по себе факт использования нейросети не делает статью плохой и не означает автоматический бан в поиске. Google прямо допускает работу с генеративными инструментами, но оценивает другую вещь: приносит ли публикация реальную пользу читателю или создана ради манипуляции поисковой выдачей. Проблема начинается в тот момент, когда автор берет черновик нейросети, не проверяет факты, не добавляет опыт и публикует как готовый материал.
-
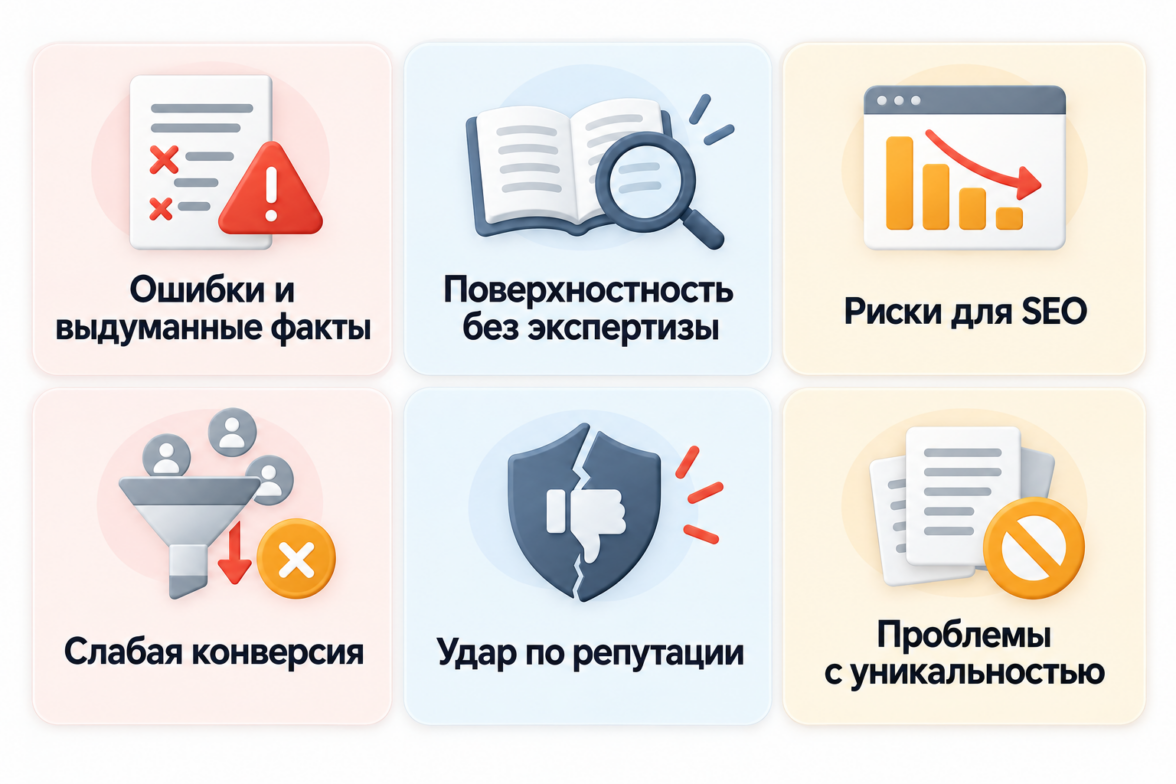
Ошибки и выдуманные факты. Нейросеть уверенно формулирует даже то, чего не знает. Она может назвать несуществующий закон, перепутать дату, приписать сервису функцию или сослаться на вымышленное исследование. В коммерческой статье такая ошибка бьет по доверию к бренду, а в материале о финансах, здоровье или праве может принести читателю реальный вред.
-
Поверхностный текст без экспертизы. Генератор быстро собирает структуру, дает определения и перечисляет очевидные советы. Но он не заменяет личный опыт, тестирование продукта, интервью с экспертами и знание контекста ниши. В результате статья выглядит гладко, но после прочтения у человека остается один вопрос: «И что мне теперь с этим делать?»
-
Проблемы с SEO. Массовая публикация неоригинальных страниц с минимальной пользой может попасть под политику Google о злоупотреблении масштабированным контентом. Правило касается не только ИИ: поисковик оценивает объем, намерение и ценность материала, независимо от того, писал его человек, редактор или алгоритм. То есть десятки однотипных статей с ключевыми словами ради позиций — рискованная тактика при любом способе производства текста.
-
Слабая конверсия. Читатель быстро чувствует шаблонность: одинаковые вступления, общие обещания, повторяющиеся формулы и отсутствие точных деталей. Такой контент способен привести трафик, но редко убеждает заказать услугу, купить продукт или оставить заявку. Особенно это заметно в обзорах, где аудитория ждет реальные плюсы, минусы, цены, сценарии работы и честные ограничения.
-
Репутационные риски. Если в тексте обнаружатся фактические ошибки, устаревшие условия тарифа или странные рекомендации, претензии получит не нейросеть, а автор или компания. Нельзя переложить ответственность на инструмент: перед публикацией материал все равно должен проверить человек, который понимает тему.
-
Сложности с уникальностью. Нейросетевой текст не всегда копирует источники дословно, но может повторять популярные структуры, формулировки и факты из обучающих данных. Поэтому проверка на плагиат и ИИ решает разные задачи: первая ищет совпадения, вторая замечает признаки генерации. Для качественной статьи нужны обе проверки, но решающим этапом остается редактура.
Я использую нейросеть как помощника для плана, черновика или списка вопросов. А затем добавляю то, чего у нее нет: свежие данные, примеры из практики, проверенные источники, позицию автора и нормальный человеческий язык. Тогда инструмент ускоряет работу, а не превращает материал в безликую страницу ради объема.
Существует ли стопроцентный способ уличить нейросеть
На сегодня ни один AI-детектор не умеет безошибочно установить, кто написал конкретный текст — человек или генеративная модель. Сервисы выдают статистическую оценку по языковым признакам, а не находят «след нейросети» как уникальный цифровой отпечаток. Поэтому высокий процент в отчете стоит воспринимать как повод внимательно изучить работу, а не как железное доказательство.
Даже крупные разработчики это признают. OpenAI закрыла собственный AI Classifier из-за низкой точности: в тестах инструмент правильно отмечал лишь 26% текстов, созданных ИИ, и в 9% случаев ошибочно относил человеческие материалы к генерации. Turnitin также подчеркивает, что его индикатор не определяет факт нарушения, а дает данные для дальнейшей оценки преподавателем или редактором.
Откуда берутся ложные срабатывания у детекторов ИИ
Ложное срабатывание означает, что сервис принимает человеческий текст за результат генерации. Это происходит не потому, что детектор «увидел нейросеть» внутри документа. Он замечает набор статистических признаков, похожих на машинный стиль: ровные предложения, предсказуемые слова, повторяемые конструкции. Иногда такой же почерк появляется у живого автора — особенно когда он пишет по шаблону, следует строгому стилю или тщательно вычитывает материал.
Вот самые частые причины, которые я встречала на практике:
-
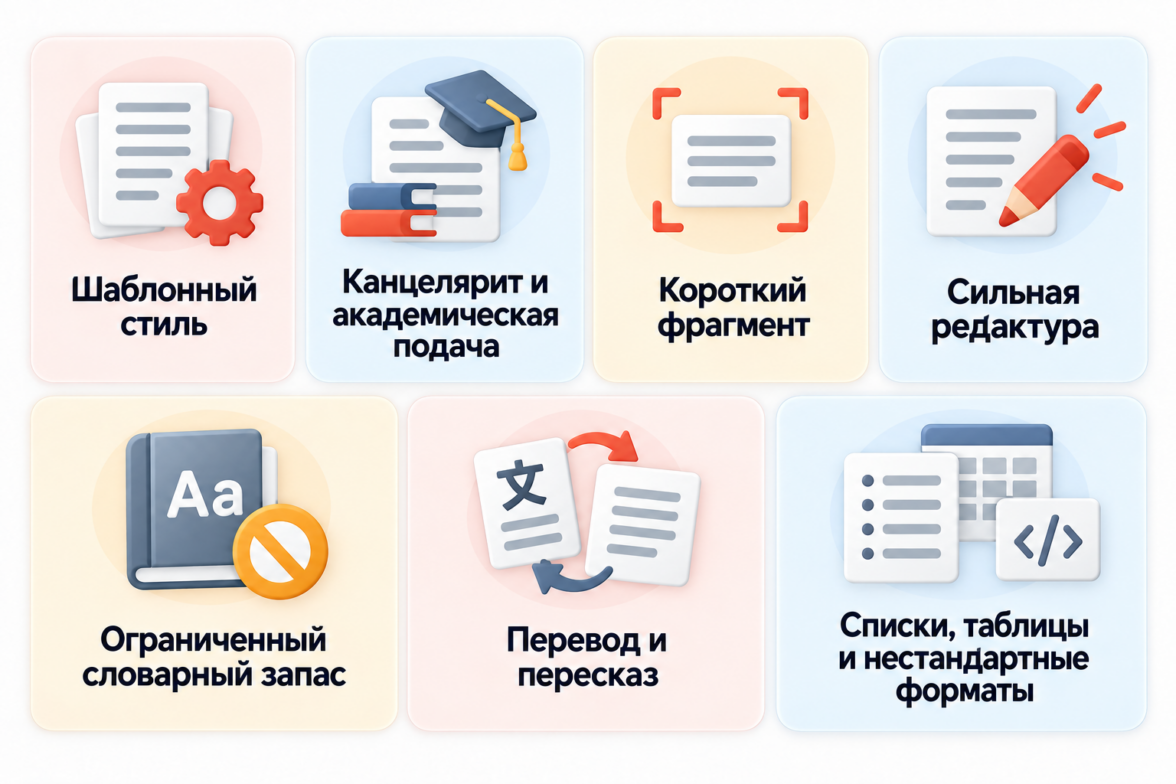
Шаблонный стиль. Инструкции, карточки товаров, юридические документы, технические описания и SEO-тексты часто построены по одной логике. В них много одинаковых конструкций и ожидаемых слов. Для детектора это выглядит подозрительно, хотя без шаблона такой формат просто не работает.
-
Канцелярит и академическая подача. Фразы вроде «в рамках данного исследования», «следует отметить», «осуществляется проверка» создают ровный и обезличенный ритм. Алгоритм может принять его за генерацию, потому что ИИ тоже любит нейтральные связки и формальные обороты.
-
Короткий фрагмент. На абзаце из нескольких предложений у сервиса слишком мало данных для нормального анализа. Даже Turnitin признавал более высокую долю ошибочных отметок, когда документ содержит менее 20% текста, который система относит к ИИ. Поэтому я не делаю выводов по проверке одного лида или описания товара на 500 знаков.
-
Сильная редактура. Парадокс, но аккуратная вычитка иногда повышает риск. Если редактор убрал разговорные слова, выровнял длину фраз и заменил живые формулировки на нейтральные, текст становится статистически «гладким». Исследования также называют профессиональную редактуру заметным фактором, который искажает выводы AI-детекторов.
-
Ограниченный словарный запас. Детекторы часто связывают ИИ с предсказуемой лексикой и простыми фразами. На англоязычной выборке семь сервисов ошибочно отметили как сгенерированные в среднем 61% работ студентов, для которых английский не был родным. Для русского языка нельзя механически переносить эту цифру, но сам принцип важен: однообразная лексика повышает риск ложной детекции на любом языке.
-
Перевод и пересказ. Машинный перевод, ручной пересказ с сохранением структуры оригинала или глубокая переработка текста могут оставить слишком ровный синтаксис. Детектору трудно отличить такой материал от генерации, потому что он не знает историю создания документа.
-
Списки, таблицы и нестандартные форматы. Многие сервисы лучше работают со связным текстом. Код, поэзия, диалоги, формулы, таблицы и маркированные списки нарушают привычный для модели паттерн, поэтому отчет может быть неточным.
Чтобы не попасть в ловушку, я смотрю на результат как на сигнал для ручной проверки. Если сервис выделил абзац, я перечитываю его, проверяю факты, добавляю конкретный пример или уточнение. А когда от оценки зависит учебная работа, публикация или решение по автору, сравниваю минимум два детектора и сохраняю черновики с историей правок.
Несколько хитростей, которые делают проверку надежнее
Детектор не превращается в идеальный инструмент, если загрузить в него любой текст. Но простая подготовка заметно снижает риск случайного результата. Я использую несколько правил, особенно когда проверяю статью для клиента, учебную работу или большой коммерческий материал.
Берите текст, а не обрывок
Не проверяйте один лид, описание карточки товара или пару абзацев. Детектору нужно достаточно данных, чтобы увидеть закономерности в лексике и синтаксисе. Например, Turnitin повысил минимальный объем для анализа со 150 до 300 слов, поскольку на более длинных текстах точность работы растет. Для собственной проверки я беру хотя бы 300-500 слов связного текста, а лучше — полноценный раздел статьи.
Убирайте все, что не является прозой
Перед запуском я удаляю ссылки, таблицы, код, списки, формулы, заголовки, подписи к изображениям и библиографию. Такие элементы не похожи на обычную речь и могут исказить статистику. Детекторы лучше справляются с цельными абзацами, где есть нормальные предложения, связки и логика повествования.
Делите большую статью по смыслу
Если сервис не принимает весь материал из-за лимита символов, не режьте текст механически через каждые 10 000 знаков. Я разбиваю статью на законченные блоки: введение, основной раздел, кейс, выводы. Так каждый фрагмент сохраняет внутреннюю логику, а результаты легче сравнить между собой.
Сверяйте хотя бы два результата
У разных сервисов разная обучающая выборка и свой набор признаков. Один детектор может увидеть 70% генерации, другой покажет 15%, и это не всегда значит, что один из них плохой. Я сначала сопоставляю отчеты, затем открываю выделенные фрагменты и ищу реальные причины: повторы, канцелярит, пустые переходы, слишком ровную структуру.
Читайте выделенные абзацы вручную
Общий процент полезен, но он не объясняет проблему. Важнее посмотреть на конкретные предложения, которые система отметила. Если в них нет ошибок, шаблонов и сомнительных утверждений, переписывать весь текст ради красивой цифры не нужно. А вот фрагменты с общими фразами, повторами и неясными выводами стоит доработать в любом случае.
Не смешивайте проверку ИИ и антиплагиат
Это два разных отчета. Антиплагиат ищет совпадения с опубликованными материалами, а AI-детектор оценивает вероятность генерации по стилю. Низкий процент ИИ не гарантирует уникальность, как и высокий процент уникальности не доказывает, что статью написал человек. Я запускаю оба инструмента, если текст идет в публикацию.
Сохраняйте историю создания материала
Если проверка важна для учебы, редакции или работы с заказчиком, сохраняйте черновики, комментарии редактора, заметки, версии документа и список источников. Эти материалы показывают реальный ход работы лучше, чем любой показатель детектора. И если сервис ошибочно отметит человеческий текст, у вас останутся понятные аргументы для разговора.
Как подружиться с детекторами ИИ и не потерять нервы
Я воспринимаю AI-детектор как подсказку, а не как окончательный вердикт. Процент генерации не доказывает, что текст создала нейросеть: он только показывает фрагменты, которые стоит перечитать. Один сервис может выдать 10%, а другой — 60%, потому что алгоритмы по-разному оценивают лексику, синтаксис и повторы. Поэтому я всегда смотрю на выделенные предложения и запускаю проверку минимум в двух сервисах.
Не стоит переписывать хороший текст ради нулевого показателя. Лучше добавить конкретные факты, примеры, личные выводы и понятные объяснения — материал станет полезнее и для читателя, и для редактора. А если от результата зависит учебная работа или сотрудничество с заказчиком, сохраните черновики, источники и историю правок. Даже Turnitin предупреждает, что отчет AI-детектора нельзя считать единственным доказательством использования нейросети.
Вопросы, которые возникают перед проверкой текста на ИИ
Когда я впервые начала тестировать AI-детекторы, вопросов оказалось больше, чем кнопок в самих сервисах. Ниже собрала короткие ответы на самые частые ситуации: от бесплатной проверки до оценки авторства и одновременного поиска плагиата.
Как проверить текст на ИИ бесплатно?
Откройте бесплатный детектор, вставьте в поле связный фрагмент текста и запустите анализ. Для первого теста удобно использовать Текстовод: сервис дает базовый доступ без оплаты и отмечает участки с признаками генерации. Однако бесплатная проверка текста на нейросеть обычно ограничена по объему или числу запусков.
Где проверить работу на ИИ, если текст написан на русском?
Выбирайте сервис для проверки текста на нейросети, который заявляет поддержку русского языка. Перед загрузкой уберите ссылки, таблицы и длинные списки: так детектор текста на использование нейросети получит цельный материал и даст более понятный результат.
Как проверить работу на использование ИИ и не сделать неверный вывод?
Запустите детекцию ИИ текста в двух разных сервисах и сравните отчеты. Затем прочитайте выделенные абзацы вручную: канцелярит, однотипные предложения и академический стиль иногда повышают процент генерации даже в авторской работе.
Реальна ли проверка работы на ИИ бесплатно для большой статьи?
Да, но чаще всего придется делить материал на части. Бесплатные версии ограничивают разовый объем или количество запросов, поэтому длинную статью лучше проверять по разделам: отдельно введение, основную часть и выводы.
Как проверить работу на плагиат и ИИ за один раз?
Некоторые платформы объединяют оба инструмента в одном личном кабинете. Но это две разные проверки: антиплагиат ищет совпадения с опубликованными материалами, а проверка текста на генерацию нейросетью анализирует стиль, лексику и структуру фраз. Поэтому смотрите оба отчета отдельно.
Можно ли узнать авторство текста через нейронную сеть?
Проверка текста на авторство нейросети не устанавливает, кто именно написал материал. Искусственный интеллект не видит паспорт автора и не находит «подпись» конкретной модели. Он оценивает вероятность генерации по статистическим признакам, поэтому результат показывает ориентир, а не доказательство.
Какой онлайн-сервис хорошо подходит для первой проверки?
Для старта выберите понятный сервис с бесплатным лимитом и отчетом с подсветкой фрагментов. Такая онлайн-проверка дает больше пользы, чем один общий процент: вы сразу видите, какие предложения стоит улучшить, добавить в них факты, авторский пример или более ясное объяснение.
Нужна ли проверка, если нейросеть помогала только с планом?
Если вы использовали ИИ для структуры, идей или чернового списка тезисов, детектор может не показать заметных признаков генерации. Но финальный текст все равно стоит перечитать: убедитесь, что каждое утверждение точное, применение терминов уместное, а материал отражает вашу авторскую позицию.
Поможет ли детектор сделать текст лучше?
Да, если воспринимать его как помощь редактору. Проверка не должна превращаться в игру с процентами. Она помогает узнать, где текст стал слишком шаблонным, а затем вернуть ему нормальный ритм, конкретику и человеческую интонацию.
Проверка текста на нейросеть помогает заметить шаблонные фразы, повторы и слишком ровную подачу до публикации. Но отчет детектора не доказывает авторство: сервис оценивает только вероятность генерации. Я советую сравнивать результаты двух инструментов, вручную читать выделенные фрагменты и отдельно проверять работу на плагиат.
А какими AI-детекторами пользуетесь вы? Поделитесь опытом в комментариях — особенно интересны случаи, когда сервис ошибся или, наоборот, помог улучшить статью.
Другие статьи