Нейросети для музыки и песен: обзор 5 лучших моделей
Представьте: вы напеваете мелодию по дороге домой, а через пару минут на руках уже есть полноценная песня с вокалом, припевом и аранжировкой. Еще несколько лет назад такое казалось фантастикой, а сегодня этим пользуются и любители, и профессиональные музыканты. В 2023 году вирусный трек с «голосами» Drake и The Weeknd, целиком созданный искусственным интеллектом, набрал миллионы прослушиваний и заставил индустрию всерьёз заговорить о будущем музыки. С тех пор нейросети стали быстрее, точнее и доступнее.
Сегодня ИИ умеет сочинять мелодии, подбирать аранжировку, синтезировать вокал, менять тембр голоса и делать звуковые эффекты. Блогерам, геймдевам, маркетологам и авторам песен это позволяет проверить идею за вечер, не арендуя студию и не ища исполнителей. Музыканты получают новый инструмент для демо и черновиков.
1. Suno
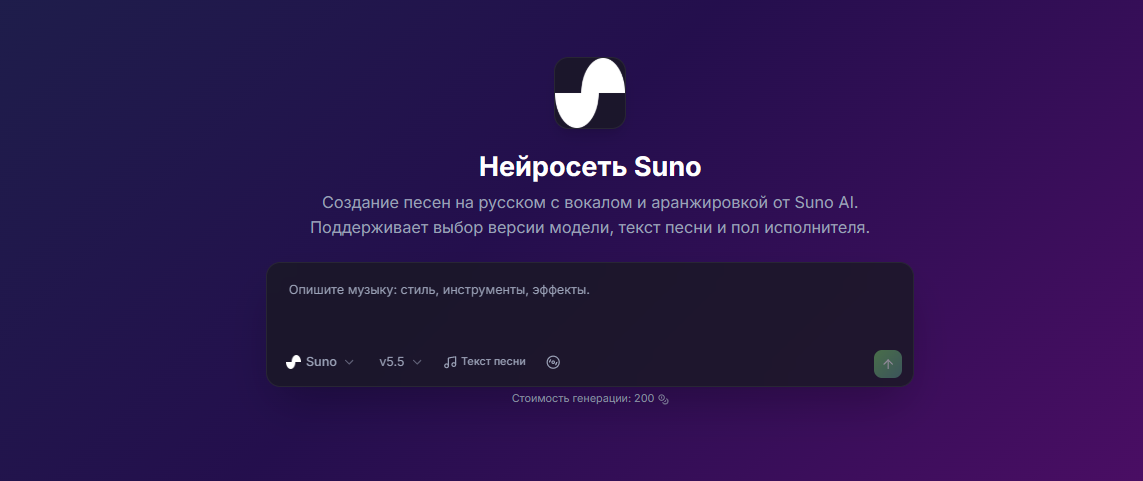
Suno — одна из самых известных нейросетей для создания песен с вокалом. На STIVA.ai доступны версии v5.5, v5, v4.5+, v4.5 и v4, так что можно выбрать, что важнее: качество или скорость. Модель принимает текстовый промпт с жанром, настроением и темпом, а также готовый текст песни, который можно разбить на секции [Verse], [Chorus] и [Bridge]. Пол исполнителя и тип вокала тоже задаются: мужской баритон, женский фальцет или хоровой припев. На выходе получается трек с вокалом и аранжировкой длительностью до четырёх минут. Сильнее всего модель в живом вокале, гармоничной аранжировке и широком охвате жанров, от поп-музыки и рока до lo-fi и баллад. Слабее другое: контроль над темпом и отдельными инструментами ограничен, а русская дикция в сложных партиях уступает английской. Чем точнее описаны жанр и вокал, тем ближе результат к задумке, поэтому удачные промпты стоит сохранять. Если трек почти идеален, но один куплет не удался, достаточно поменять текст этого куплета и перегенерировать результат.
2. MiniMax Music V2.6
MiniMax Music V2.6 — модель генерации песен с вокалом от китайской лаборатории MiniMax. Её главная особенность в том, что она понимает структуру песни. Достаточно разметить текст тегами [Verse], [Chorus] и [Bridge], и модель построит композицию с правильными переходами между куплетом, припевом и бриджем. В промпте можно указать жанр, темп в BPM, эмоцию и тембр вокала, например: «энергичный поп, 120 BPM, женский вокал». Модель поддерживает десятки жанров, включая поп, R&B, рок, хип-хоп, электронику, фолк и баллады. Одна генерация занимает в среднем меньше минуты, поэтому варианты можно быстро перебирать. Недостатков тоже хватает: русский вокал звучит с акцентом и иногда искажает слова, полный трек приходится склеивать из нескольких фрагментов, а стемы, то есть раздельные дорожки вокала и инструментов, недоступны. Зато для демо-треков, роликов, рилсов и обучающих песенок модель подходит отлично. Лучше всего работают один-два куплета и припев, потому что слишком длинный текст ухудшает структуру трека.
3. Stable Audio 3
Stable Audio 3 — свежая версия аудиомодели от Stability AI, которая создаёт музыку и звуковые эффекты по текстовому описанию. Это не модель для песен с вокалом, а инструмент для инструментальной музыки, фоновых треков и SFX. Длительность можно выбрать от 5 до 180 секунд, так что короткий звук для интерфейса и протяжный ambient-трек получаются одинаково просто. Модель работает на диффузионной архитектуре, а качество настраивается под задачу: можно выбрать скорость генерации или более детальный результат. Промпт удобнее всего строить из конкретных музыкальных терминов: жанр, BPM, инструменты, настроение и сцена. Пример такого описания: «lo-fi hip-hop, 85 BPM, акустическое пианино, без вокала». Минус в том, что готовое аудио нельзя отредактировать, и при любой правке генерацию придётся запускать заново. Модель также лучше понимает английские промпты. Подходит она для видео, подкастов, игр и прототипов саундтреков. Для коротких звуков выбирайте короткую длительность, а для фоновой музыки длинный режим.
4. Stable Audio 2.5
Stable Audio 2.5 — предыдущая версия того же семейства. Она создаёт структурированные треки до трёх минут с интро, развитием и финалом. Сильная её сторона — студийное качество звука в формате 44,1 кГц стерео и обучение на лицензированных данных, что важно для коммерческих проектов. Ритмическая сетка держится ровно, а минутный трек генерируется за считаные секунды, так что идеи удобно прототипировать. Подходит модель для саундтреков, джинглов, ambient-фонов и звуков для приложений. Ограничения тоже есть: вокал у модели получается плохо, она часто поёт «абракадабру» вместо осмысленных слов. Русский язык она понимает хуже английского, поэтому музыкальные термины лучше писать по-английски. Выбирают её, когда нужна инструментальная музыка с понятной лицензией для рекламы, игр и презентаций. Модель умеет создавать лупы, которые зацикливаются без заметного шва, и это особенно полезно в играх. Обычно достаточно нескольких точных слов о жанре и инструментах, а лишние эпитеты только запутывают модель.
5. ElevenLabs Voice Changer
ElevenLabs Voice Changer — инструмент американской компании ElevenLabs для смены голоса в готовых аудиозаписях, доступный на STIVA.ai. Это не генератор песен с нуля. Вы загружаете свою запись, например черновой вокал или напетую мелодию, а модель переносит все интонации, паузы и эмоции на другой голос из библиотеки или на ваш клонированный голос. Работает инструмент с MP3, WAV, M4A и FLAC, обрабатывает записи до десяти минут и поддерживает более 30 языков, включая русский. Баланс между сходством с оригиналом и выразительностью настраивается параметрами stability, similarity и style. Главное требование к записи — чистый исходник без музыки и шума, потому что модель воспринимает фон как часть голоса. Клонировать чужой голос без согласия запрещено условиями сервиса. Инструмент полезен для демо песен, многоголосых аранжировок и озвучки персонажей в музыкальных проектах. Результат удобно проверять в наушниках, потому что артефакты на шипящих звуках и стыках слов слышны именно там.
Как выбрать модель
Если нужна готовая песня с вокалом, начинайте с Suno или MiniMax Music. Когда важны инструментальные треки, фоновая музыка и звуковые эффекты, выбирайте Stable Audio. Если запись голоса уже есть и её хочется переозвучить, подойдёт ElevenLabs Voice Changer. Все эти модели доступны на STIVA.ai в одном интерфейсе, без отдельной регистрации у каждого провайдера.
Что такое нейросеть для музыки и песен
Нейросеть для музыки — это модель машинного обучения, которая создаёт аудио по текстовому описанию или по другому входному материалу. Такие модели обучаются на огромных массивах музыки и умеют воспроизводить жанры, инструменты, ритм и вокальные интонации. Нейросеть для песен добавляет к этому пение: по вашему тексту она синтезирует голос и накладывает на него аранжировку.
Инструменты делятся на три группы. К первой относятся генераторы песен с вокалом, например Suno и MiniMax Music. Вторая группа — аудиомодели для инструментальной музыки и звуковых эффектов, среди них Stable Audio. Третья группа работает с готовым голосом: сюда входит ElevenLabs Voice Changer, который меняет тембр записи.
Как создать песню нейросетью: пошагово
Начать стоит с вопроса, зачем нужен трек. Песня с вокалом, фоновая музыка для видео и звуковой эффект решаются разными моделями, поэтому сначала определите задачу. Затем выберите инструмент: для песен подойдут Suno и MiniMax Music, для инструментала лучше Stable Audio. Следующий шаг — промпт, в котором указаны жанр, настроение, темп в BPM, инструменты и тип вокала. Если вы пишете песню сами, добавьте текст и разметьте его тегами [Verse], [Chorus] и [Bridge]. Запустите генерацию и сравните несколько вариантов, потому что первый результат редко оказывается идеальным. Наконец, поправьте промпт и повторите попытку, меняя за раз только один параметр, чтобы понимать, что именно повлияло на звучание.
Все эти действия удобно совершать в STIVA.ai, где несколько музыкальных моделей собраны в одном интерфейсе. Результаты можно сравнивать без регистрации у каждого провайдера отдельно.
Как написать хороший промпт для музыки
Промпт — главный инструмент управления результатом, и чем конкретнее описание, тем точнее звучание. Хорошая формула выглядит так: жанр, темп, инструменты, настроение и тип вокала. Сравните два описания. Первое, «красивая песня про любовь», почти ничего не задаёт. Второе, «меланхоличная поп-баллада, 75 BPM, женский вокал, фортепиано и струнные, тема первой любви», уже даёт модели опору.
Несколько простых правил помогают в работе. Указывайте жанр вместе с поджанром: «lo-fi hip-hop» звучит точнее, чем просто «электроника». Добавляйте BPM или слова вроде «медленный» и «энергичный». Перечисляйте инструменты, например acoustic guitar, cello или soft piano. Не пишите противоречий, потому что фраза «тихий и громкий» снижает качество. Если нужна инструментальная музыка, прямо укажите «без вокала».
Какая нейросеть для музыки лучше всего подходит под задачу
Для песни с текстом и живым вокалом выбирайте Suno, а если важна работа со структурой куплет–припев–бридж, попробуйте MiniMax Music V2.6. Фоновая музыка, джинглы и ambient лучше получаются у Stable Audio 3, где длительность гибко настраивается от 5 до 180 секунд. Для треков до трёх минут в студийном качестве подойдёт Stable Audio 2.5. Если нужно сменить голос в записи, пригодится ElevenLabs Voice Changer, который переносит интонации на другой тембр.
Русский текст тоже работает, но большинство моделей лучше понимает английский вокал и английские промпты. Русская дикция в песнях пока уступает английской, поэтому для важных проектов результат стоит проверить на слух.
Права на музыку, созданную нейросетью
Условия использования у каждого сервиса свои. Прежде чем выпускать трек на стриминговых платформах или использовать его в рекламе, внимательно прочитайте лицензию конкретной модели. Stable Audio 2.5 обучена на лицензированных данных и позиционируется для коммерческого применения. Клонировать чужой голос без согласия запрещено, и это касается большинства сервисов.
Частые вопросы
Можно ли создать песню нейросетью без музыкального образования?
Да. Нужны только идея, текст и понятное описание желаемого звучания. Для первого результата обычно хватает одного-двух промптов.
Чем нейросеть для песен отличается от озвучки текста?
Озвучка читает текст, а генератор песен поёт его под музыку с аранжировкой. Для песни нужен инструмент вроде Suno или MiniMax Music, а не TTS.
Сколько длится трек?
Зависит от модели. У Suno и Stable Audio 2.5 треки достигают нескольких минут, у MiniMax Music генерация обычно короче, и для полного трека фрагменты склеивают.
Нужно ли знать английский?
Для лучших результатов — да, особенно для промптов. Русскоязычные описания тоже работают, но точность может быть ниже.
Вывод
Нейросети для музыки и песен уже стали практичным инструментом для авторов, блогеров, маркетологов и музыкантов. Они экономят время на черновиках и позволяют проверить идею за несколько минут. Начните с одной модели, освойте формулу промпта и постепенно подключайте остальные инструменты. Попробовать можно на STIVA.ai.
Другие статьи