«Мои слезы»: как повторить вирусный ИИ-тренд
Все нейросети для генерации трендовых фото и видео собраны в агрегаторе STIVA.ai. Новым пользователям начисляется 100 приветственных токенов, которые сразу можно потратить на генерацию.
 СТИВААгрегатор нейросетей
Что понадобится:
-
Фото героя анфас — ровный свет, без очков, волосы не закрывают лицо. Второе фото, если героев двое.
-
Нейросеть для изображений — чтобы собрать стартовый кадр.
-
Нейросеть для видео — чтобы оживить сцены.
-
CapCut или любой другой редактор.
-
Трек: песня Светы «Мои слезы» есть в звуковых библиотеках соцсетей.
Фото — самый важный пункт. Модель не придумывает внешность, а переносит то, что видит: если на референсе половина лица в тени, вторую половину она дорисует по своему усмотрению
Шаг 1. Стартовый кадр
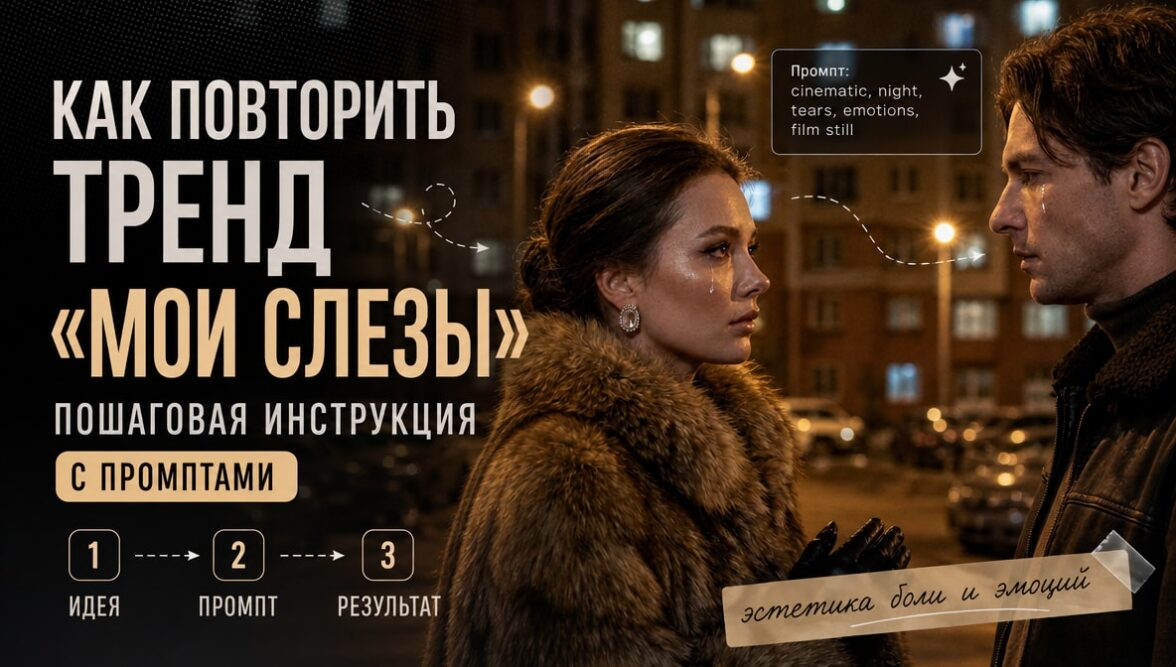
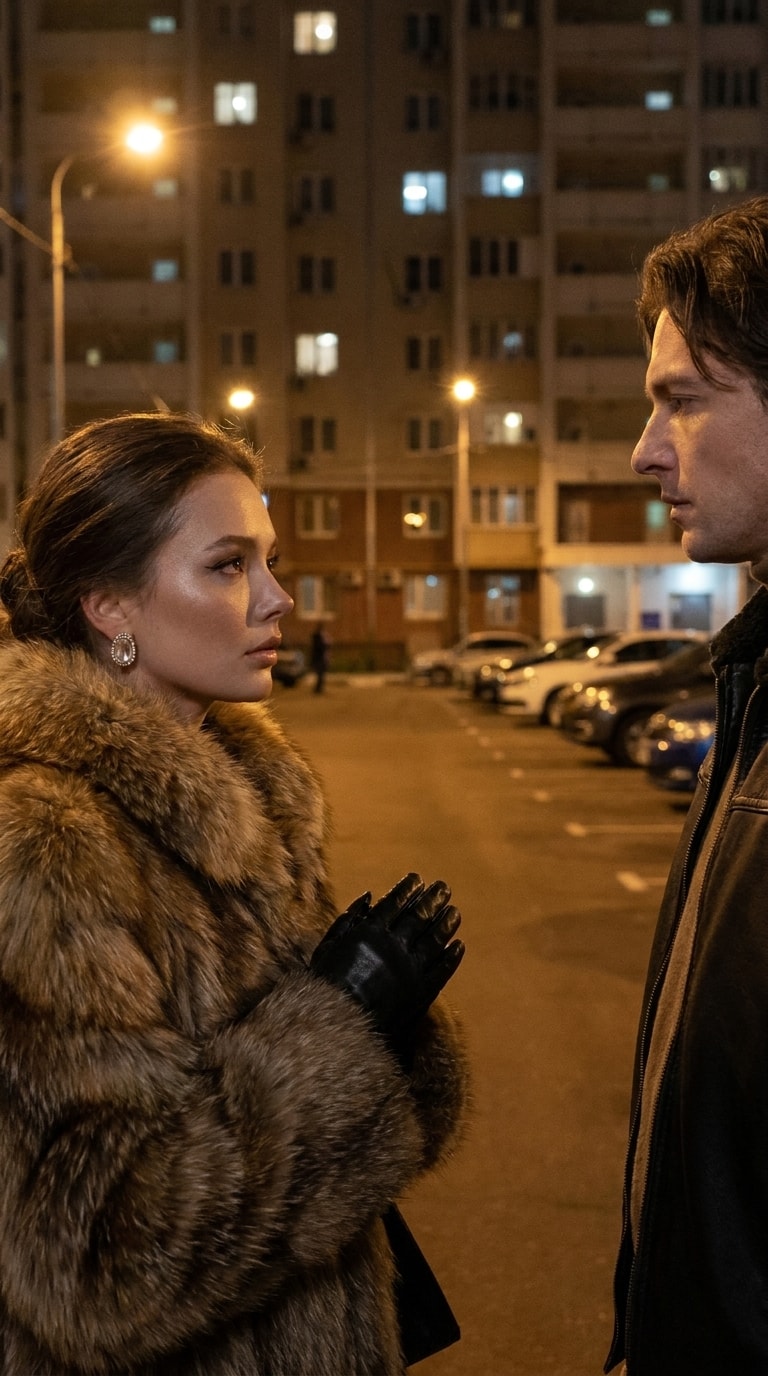
Загрузите фотографии героев в генератор изображений — через раздел нейросетей для фото или инструмент ИИ-фото. Задача — получить один общий кадр с двумя персонажами на ночной парковке.
Промпт для изображения
Возьми прикреплённую фотографию за основу для максимально достоверного воспроизведения внешности центрального персонажа. Создай атмосферный кадр в эстетике современного реалистичного кино. Действие разворачивается поздней ночью в обычном городском дворе, среди высотных жилых зданий, в окнах которых местами горит свет. На небольшой парковочной площадке двое людей остановились практически вплотную друг к другу. Они стоят напротив, не разрывая напряжённого зрительного контакта, словно между ними происходит важный личный разговор.Окружающее пространство наполнено приглушённым золотистым свечением уличных фонарей. В глубине композиции виднеются припаркованные автомобили, фасады многоэтажек и характерные детали ночного жилого района. Камера фиксирует обоих участников сбоку, на среднем расстоянии, отчётливо показывая их профили, положение тел и эмоциональную атмосферу момента.Особое внимание удели естественной анатомии, достоверной фактуре кожи, детализации одежды и правдоподобному взаимодействию света с поверхностями. Внешность главного персонажа должна полностью соответствовать загруженному референсу: сохрани индивидуальные особенности лица, возраст, причёску и пропорции без стилизации и изменений. Избегай искусственной ретуши, анатомических искажений и мультяшности. Кинематографичная композиция, фотореализм, мягкая глубина резкости, вертикальное соотношение сторон 9:16.
Из нескольких вариантов выберите тот, где лица наиболее похожи на референсы и хорошо читается профиль. Дальше работаем только с ним.
Шаг 2. Первый герой начинает петь (4 секунды)
Кадр загрузите в Kling 3 Motion Control или Seedance в режиме «видео по изображению». Остальные модели — в разделе генерации видео.
Промпт для видео
Преврати предоставленный статичный кадр в короткий фотореалистичный видеофрагмент, сохранив атмосферу напряжённого ночного диалога между двумя персонажами. Центральный герой удерживает пристальный зрительный контакт с человеком напротив и постепенно начинает эмоционально исполнять музыкальную фразу без слышимого голоса. Его губы двигаются мягко, ритмично и естественно, имитируя пение с правдоподобной артикуляцией. Во взгляде читаются серьёзность, искренние переживания и внутренняя напряжённость. Едва заметные повороты и наклоны головы, движения бровей и изменения выражения лица подчёркивают глубину момента.Собеседник остаётся безмолвным, внимательно наблюдает за главным героем и реагирует лишь минимальными естественными микродвижениями, не нарушая зрительного контакта. Камера непрерывно и практически незаметно движется вперёд, постепенно сокращая расстояние до лица центрального персонажа и усиливая эмоциональную выразительность сцены.Полностью сохрани визуальную идентичность обоих людей: черты и пропорции лиц, причёски, возраст, одежду и первоначальное расположение в кадре. Ночная городская локация, окружающие объекты, цветовая температура и характер освещения должны оставаться неизменными на протяжении всего видео. Исключи деформацию лиц, неестественную артикуляцию, резкие движения, смену ракурса, монтажные склейки и появление новых элементов.Максимально реалистичная анимация, кинематографичная глубина изображения, плавное приближение камеры одним непрерывным дублем. Вертикальное соотношение сторон 9:16, продолжительность ровно 4 секунды.
Шаг 3. Ответ второго персонажа (4 секунды)
Референсом берите последний удачный кадр предыдущего фрагмента плюс исходное фото героя. Так модель не «забудет» внешность на второй итерации.
Промпт для видео
Продолжи предыдущую ночную сцену, сохраняя атмосферу и композицию. Второй персонаж, глядя собеседнику в глаза, начинает эмоционально и беззвучно исполнять строчку песни. Губы двигаются плавно и естественно, мимика передаёт искренние переживания. Лёгкие наклоны головы подчёркивают эмоции. Первый герой молча слушает, сохраняя зрительный контакт.Камера медленно приближается к лицу второго персонажа, переходя на выразительный крупный план. Внешность, причёски, возраст, одежда, освещение и ночной фон остаются неизменными. Без искажений лиц, резких движений и монтажных переходов. Фотореализм, один непрерывный кадр, вертикальный формат 9:16, ровно 4 секунды.
Шаг 4. Финальная сцена (5 секунд)
Промпт для видео
Создай кинематографичное завершение ночной сцены. Герои стоят почти вплотную, не отводя друг от друга взгляда. Один персонаж заканчивает беззвучно петь, его губы постепенно останавливаются, а лицо становится задумчивым. Второй отвечает едва заметной грустной улыбкой. Эмоции сдержанные, искренние и естественные. Камера плавно перемещается вбок, показывая оба лица в профиль. На фоне остаются ночные многоэтажки со светящимися окнами, припаркованные автомобили и тёплый свет фонарей. Полностью сохрани внешность, возраст, причёски, одежду и окружение. Без деформаций, смены ракурса и монтажных склеек. Максимальный фотореализм, непрерывная съёмка, вертикальный формат 9:16, ровно 5 секунд.
Шаг 5. Монтаж и звук
-
Закиньте три фрагмента в CapCut в нужном порядке: сцена 1 → сцена 2 → сцена 3.
-
Подрежьте лишние кадры на стыках: движение камеры между отдельными генерациями почти всегда чуть расходится.
-
Наложите трек и подгоните сцены под фразы песни.
-
Добавьте субтитры с первой строчкой в нижней трети и легкое пленочное зерно — оно убирает «пластиковую» гладкость ИИ-картинки.
-
Проверьте общую длину: 12–15 секунд, песня стартует с первого кадра, без разгона.
Если нужен собственный трек вместо готового, его можно собрать в разделе генерации музыки.
Почему меняются лица и как это исправить
При самостоятельной генерации нейросеть иногда искажает черты персонажей, путает их местами или неточно передает мимику губ. Причина не в «плохой модели», а в том, как она читает референс: чем меньше информации о лице, тем активнее она додумывает, а каждая новая генерация добавляет небольшие отклонения.
Что помогает:
Фото анфас при хорошем свете. Даже если в итоговом кадре герой стоит боком, модели нужно видеть лицо целиком.
Расположение героев прямо в промпте. Указывайте, кто слева, кто справа, и добавляйте «не смотрят в камеру, серьезное выражение лица без улыбки».
Продолжение с последнего удачного кадра. Не начинайте каждую сцену с нуля — так сохраняются свет, одежда и внешность.
Не больше двух героев в кадре. Третий персонаж забирает внимание модели, и лица «поедут».
Сцены по очереди. Генерировать все три сразу — верный способ получить трех разных людей к финалу.
Если второго фото нет, поставьте героя напротив зеркала, витрины или стекла машины — зрительный контакт в кадре сохранится.
Чек-лист перед публикацией
-
Вертикаль 9:16, длительность 12–15 секунд.
-
Лицо героя анфас, черты не меняются от сцены к сцене.
-
Губы попадают в ритм трека.
-
Ночной фон и освещение одинаковые во всех фрагментах.
-
Нет резких стыков и скачков цветовой температуры.
-
Первые 0,5 секунды — уже песня.
-
Субтитры не перекрывают лица.
Частые вопросы
Нужны ли навыки работы с нейросетями?
Базово нет. Нужна аккуратность: один статичный кадр, три коротких видео, склейка. Промпты выше можно копировать как есть.
Сколько времени занимает?
20–30 минут, если дубли удачные. Дольше всего ищется стартовый кадр — он задает свет и композицию всего ролика.
Что делать, если губы не попадают в музыку?
Подгонять не песню, а длительность сцен: подрежьте фрагменты под фразы трека. И проверьте, что в промпте есть «беззвучно поет» — иначе модель рисует случайную мимику.
Можно ли поменять локацию?
Да. В промптах замените ночной двор на крышу, кухню или салон машины — остальные формулировки про сохранение внешности и света работают так же. Все модели есть на STIVA.ai, начинать удобнее с раздела генерации видео.
Итог: стартовый кадр, три сцены по 4–5 секунд и склейка с треком. Этого достаточно, чтобы повторить тренд «Мои слезы» и дальше менять декорации под себя — двор, крышу, кухню, последний вагон метро.
Другие статьи