Нейросети для аудио и звука 2026 году: ТОП-8 ИИ-инструментов для работы со звуками
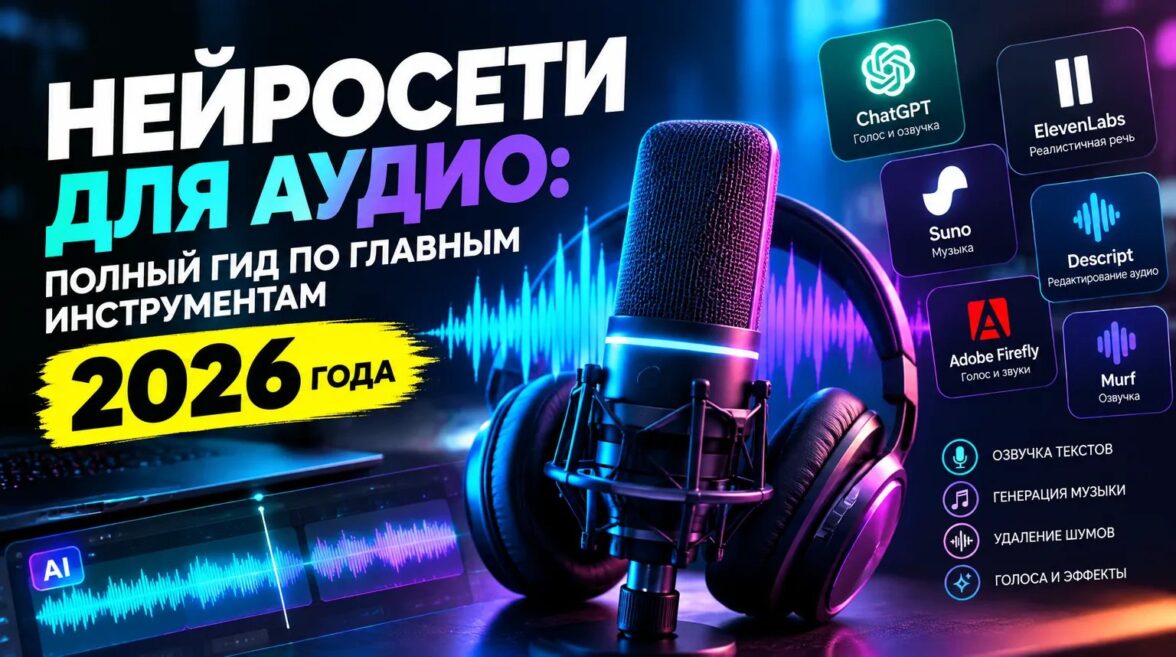
Ещё недавно нейросетевой звук ассоциировался прежде всего с механической речью и простыми короткими эффектами. Сейчас ситуация изменилась: ИИ способен создавать полноценные песни с вокалом, озвучивать книги на разных языках, генерировать саунд-дизайн, менять голос в готовой записи и поддерживать практически живой разговор.
Все модели для генерации и обработки аудио доступны в агрегаторе STIVA.ai. Платформа даёт доступ к современным ИИ-моделям без VPN и зарубежных банковских карт. Для новых пользователей предусмотрено 100 приветственных токенов бесплатно.
 STIVA.aiАгрегатор нейросетей
Лучшие ИИ инструменты для работы с аудио и звуком
ИИ-инструменты значительно упрощают работу с аудио: помогают очищать записи от шума, улучшать качество звука, расшифровывать речь и даже создавать голосовой контент. Ниже собрали лучшие ИИ-сервисы для работы с аудио и звуком, которые подойдут для разных задач — от обработки подкастов до профессионального монтажа.
1. Голосовые ассистенты
ChatGPT Голос (Advanced Voice Mode)
Голосовой режим ChatGPT от OpenAI предназначен прежде всего для общения, а не для создания готовых аудиофайлов. В отличие от классической цепочки «распознавание → текст → ответ → синтез», современные модели работают с речью напрямую и учитывают темп, паузы, интонацию и другие особенности разговора.
Режим поддерживает живой диалог: ассистента можно перебить, попросить изменить манеру речи, говорить тише или эмоциональнее. Доступна работа с несколькими языками — можно вести разговор на разных языках и переключаться между ними по ходу беседы. Пользователю доступно несколько вариантов звучания с разным характером. Базовая голосовая функция доступна бесплатно с ограничениями, расширенные возможности зависят от тарифа.
Такой режим удобен для разговорной практики, подготовки к интервью, изучения языков, голосовых заметок и повседневного общения. Для коммерческой записи дикторских материалов он не предназначен. Возможности экспорта и коммерческого использования аудио ограничены, а качество речи на некоторых менее распространённых языках может быть нестабильным.
2. Синтез речи и работа с голосом: ElevenLabs
ElevenLabs объединяет несколько специализированных инструментов, которые закрывают разные задачи: от озвучки текста до создания эффектов и замены голоса.
ElevenLabs Озвучка (Text to Speech)
ElevenLabs Озвучка преобразует текст в естественную речь, стараясь сохранить характерные для человеческого голоса паузы, эмоции и интонационные переходы. Поддерживается 70+ языков, в том числе русского, доступна большая коллекция готовых голосов и функция Voice Design для создания собственного варианта по описанию. Поддерживается клонирование голоса в режимах Instant и Professional, эмоциональная подача с помощью текстовых указаний в Eleven v3, а также API с небольшой задержкой для чат-ботов, игровых персонажей и голосовых агентов.
Бесплатный тариф предоставляет около 10 000 кредитов в месяц. Платные варианты начинаются примерно от $6 в месяц и включают коммерческую лицензию. Инструмент особенно полезен для аудиокниг, роликов, рекламы, подкастов, курсов и голосовых интерфейсов.
ElevenLabs Sound Effects
Генератор ElevenLabs Sound Effects превращает текстовое описание в готовый звуковой эффект. Пользователь может описать практически любую сцену или источник звука. Доступны генерация бытовых, природных, кинематографических и игровых эффектов, создание коротких фрагментов продолжительностью от долей секунды примерно до 22–30 секунд в зависимости от версии, настройка влияния промпта на итоговый результат, автоматический подбор длительности и создание нескольких уникальных вариантов для последующего выбора.
Ориентировочно одна генерация стоит около 200 кредитов, а через API стоимость составляет примерно $0,12 за минуту аудио. Сервис пригодится разработчикам игр, монтажёрам, саунд-дизайнерам, авторам рекламы, видео и подкастов.
ElevenLabs Voice Changer
ElevenLabs Voice Changer заменяет голос в существующей записи, сохраняя при этом исполнение: интонацию, темп, эмоциональную окраску и особенности подачи. Поддерживается преобразование речи или вокала в один из тысяч доступных голосов, работа с 70+ языками, возможность заменить черновую запись на более качественный голос без потери живой манеры исполнения, а также работа через API, включая быструю обработку аудио.
Технология полезна при создании игровых персонажей, обработке подкастов, изменении голоса и работе с вокальными партиями. Итоговое качество напрямую связано с исходной записью: шум и плохое качество сигнала могут заметно ухудшить результат.
3. Генерация музыки
Suno
Suno позволяет создавать полноценные песни по текстовому описанию или готовой лирике. Сервис формирует вокал, аранжировку, куплеты и припевы. Актуальная версия — v5.5, выпущенная в марте 2026 года. Модель создаёт реалистично звучащий вокал в самых разных жанрах, поддерживает Voices для генерации песен с голосом пользователя после прохождения необходимой проверки, обучение Custom Models на собственной коллекции треков, персонализацию рекомендаций через My Taste, управление структурой композиции и стилем с помощью текстовых указаний, а также разделение готовой композиции на отдельные стемы для дальнейшего монтажа.
Есть бесплатный тариф с ограничениями. Платные планы начинаются примерно от $10 в месяц и включают возможности коммерческого использования. Suno удобен музыкантам, авторам контента и пользователям, которым хочется быстро превратить текстовую идею в полноценную песню.
MiniMax Music 2.6
Музыкальная модель MiniMax создаёт треки на основе текста песни и описания стиля. При необходимости можно выбрать инструментальный режим без вокала. В версии 2.6 появилась генерация инструментальной музыки по описанию и автоматическое написание текста, если поле с лирикой оставить пустым.
Из версии 2.5 перешли реалистичный вокал с дыханием и естественной динамикой, более 14 структурных тегов для управления развитием композиции, настройка BPM и тональности через промпт, расширенный набор инструментов, включая оркестровые и традиционные, генерация треков длиной до 6 минут, до 3500 символов текста и до 2000 символов описания стиля. Наиболее стабильные результаты обычно получаются на английском и китайском. Русская речь поддерживается, но может звучать менее предсказуемо.
MiniMax Music особенно интересен разработчикам и авторам, которым требуется программный доступ и более точный контроль параметров композиции. API доступен через Replicate, WaveSpeed и другие площадки.
Stable Audio 2.5
Stable Audio 2.5 от Stability AI ориентирована прежде всего на бренды, агентства и профессиональные продакшн-команды. Модель была представлена в сентябре 2025 года. Она создаёт структурированные треки длительностью до 3 минут, поддерживает стерео 48 кГц для профессионального производства, управление жанром, настроением и развитием трека обычным языком, Audio-to-Audio и инпейнтинг для изменения существующего материала, а также использование лицензированных обучающих данных и защитных фильтров. Доступно дообучение под фирменную звуковую библиотеку компании.
Модель рассчитана на саунд-брендинг, рекламу, музыку для сервисов и приложений, а также масштабные корпоративные контент-процессы.
Stable Audio 3
Stable Audio 3 — новое поколение моделей Stability AI, представленное в мае 2026 года. Важная особенность семейства — открытые веса и несколько вариантов модели: Small, Medium и Large. Модель создаёт стереотреки длиной до 6 минут 20 секунд с частотой 44,1 кГц, генерирует музыку и звуковые эффекты, редактирует отдельные участки аудио с помощью инпейнтинга, продолжает существующие треки, использует переменную длину генерации и быстро создаёт длинные аудиофрагменты на мощном GPU. Модель можно запускать локально: Small рассчитана в том числе на MacBook Pro без отдельной видеокарты.
Stable Audio 3 стоит рассматривать разработчикам, исследователям и студиям, которым важны локальная работа, контроль над данными и возможность интеграции модели в собственные продукты.
Какую нейросеть выбрать для конкретной задачи
📌 Для голосового общения, языковой практики и репетиций лучше всего подходит ChatGPT Голос.
📌Для аудиокниг, видео, курсов и профессиональной озвучки стоит выбрать ElevenLabs Озвучку.
📌Для звуковых эффектов в видео и играх оптимален ElevenLabs Sound Effects, а для замены голоса с сохранением исходной подачи — ElevenLabs Voice Changer.
📌Для быстрой генерации полноценной песни подойдёт Suno, а для управления структурой, BPM и тональностью через API — MiniMax Music 2.6.
📌Корпоративный саунд-дизайн и проекты с повышенным вниманием к лицензированию лучше доверить Stable Audio 2.5, а локальную генерацию музыки и работу с открытыми моделями — Stable Audio 3.
Главные тенденции генеративного аудио
Первая тенденция — переход от коротких фрагментов к полноценным трекам. Современные системы способны создавать композиции продолжительностью несколько минут и формировать внятную структуру. Вторая — рост персонализации: клонирование голоса позволяет использовать собственную манеру звучания в новых проектах. Третья — развитие открытых моделей. Stable Audio 3 показывает, что сложные аудиомодели всё чаще можно запускать локально. Четвёртая — голос становится полноценным интерфейсом: разговорные режимы и низколатентные API делают общение с ИИ всё более естественным. Наконец, лицензирование приобретает особое значение: для бизнеса важны не только качество результата, но и понятные условия его использования.
Генеративный звук уже вышел за рамки экспериментов. Сегодня это рабочий инструмент для музыкантов, монтажёров, маркетологов, разработчиков и создателей контента.
Нейросети для аудио: генерация, обработка, расшифровка и создание звуков
Современные ИИ-сервисы заметно упрощают работу с аудио. Они способны генерировать музыку и эффекты, преобразовывать текст в речь, распознавать записи, переводить голос, очищать звук от шума и редактировать готовые дорожки.
Такие решения подходят как профессионалам из музыкальной и видеосферы, так и обычным пользователям. Многие из них работают онлайн и не требуют сложного программного обеспечения.
Что умеют нейросети для аудио
В зависимости от конкретного сервиса искусственный интеллект может создавать речь по текстовому запросу, генерировать музыку и звуковые эффекты, превращать текст в аудиозапись, распознавать человеческую речь, переводить аудио в текст, переводить речь на другие языки, удалять шум и посторонние звуки, повышать качество голоса, создавать звуковое сопровождение для видео и редактировать аудиозаписи. Поэтому выражение «нейросеть для аудио» сегодня охватывает сразу несколько разных классов инструментов.
Бесплатные нейросети для аудио
Для простых задач необязательно покупать профессиональную подписку. Бесплатные инструменты позволяют создавать голосовые дорожки, расшифровывать интервью, экспериментировать со звуками и выполнять базовую обработку. Обычно бесплатные тарифы ограничивают длительность файлов, число генераций или набор доступных функций. Для повседневного использования этих возможностей часто хватает.
Например, бесплатный сервис можно применить для быстрой расшифровки разговора, озвучки короткого видео или удаления фонового шума.
Нейросеть для генерации аудио
Генеративные модели создают аудиоконтент на основе текстового описания или другого входного материала. Пользователь формулирует задачу, а модель формирует соответствующую дорожку. В зависимости от выбранного сервиса результатом может стать музыкальная композиция, голосовая дорожка, атмосферный фон, звуковой эффект, короткий аудиофрагмент или музыка для видео или подкаста. Особенно полезны такие решения авторам, которым регулярно требуется много оригинального звукового контента.
Нейросеть для создания аудио
ИИ можно использовать для автоматизированного производства различных звуковых материалов: от рекламной озвучки до сопровождения презентаций, подкастов и обучающих роликов. Главное преимущество здесь — скорость. Вместо поиска студии и организации записи достаточно подготовить текст и получить готовую дорожку за короткое время. Современные модели также позволяют менять тембр, интонацию и эмоциональную подачу речи.
Нейросеть для аудио из текста
Технология Text-to-Speech (TTS) преобразует написанный текст в звучащую речь. Она подходит для озвучки статей, создания роликов, аудиокниг, рекламных материалов, обучающих курсов, презентаций и голосовых сообщений. Обычно процесс выглядит просто: пользователь вводит текст, выбирает голос и параметры звучания, после чего получает готовый аудиофайл.
Нейросеть для расшифровки аудио
Обратная задача также давно автоматизирована. ИИ распознаёт речь в записи и переводит её в текст. Это удобно при работе с интервью, лекциями, совещаниями, телефонными разговорами и диктофонными файлами. Современные системы умеют определять нескольких говорящих, автоматически расставлять знаки препинания и структурировать полученную расшифровку.
Нейросеть для расшифровки аудио в текст
Автоматическая транскрибация избавляет от необходимости многократно переслушивать запись и вручную переносить реплики в документ. Достаточно загрузить аудиофайл, дождаться обработки и проверить готовый текст. После этого расшифровку можно отредактировать. Точность зависит от качества исходного материала, языка, фоновых шумов и особенностей речи.
Нейросеть для перевода аудио
Перевод аудио обычно объединяет три этапа: распознавание речи, машинный перевод и повторный синтез голоса. Исходную запись можно преобразовать в текст, перевести его и затем создать новую голосовую дорожку на другом языке. Это особенно удобно для видео, интервью, образовательных материалов и международных проектов. Некоторые современные решения стараются сохранять темп и характер оригинальной подачи, благодаря чему перевод звучит естественнее.
Нейросеть для звука
Понятие «нейросеть для звука» шире и включает инструменты для генерации, анализа и обработки аудиоматериалов. ИИ может работать с речью, музыкой, шумами и отдельными эффектами. Поэтому такие технологии применяются в кино и видеопроизводстве, играх, рекламе, подкастах и музыкальной индустрии.
Нейросеть для генерации звуков
Генераторы звука создают отдельные эффекты по текстовому описанию. Можно задать сцену с дождём, городским шумом, шагами, закрывающейся дверью или звуками природы, после чего модель сформирует подходящий аудиофрагмент. Такой подход сокращает время, которое раньше приходилось тратить на поиск нужного эффекта в фонотеках.
Бесплатная нейросеть для звуков
Если эффекты требуются время от времени, достаточно бесплатного тарифа подходящего сервиса. Обычно он позволяет создать ограниченное количество генераций или короткие фрагменты. Для небольших роликов, презентаций и тестирования возможностей ИИ этого может быть вполне достаточно.
Нейросеть для создания звуков
Генератор можно настроить под конкретную сцену видеоролика. Вместо поиска готового файла пользователь описывает необходимый звук и получает несколько вариантов. ИИ также способен создавать фоновые шумы и атмосферные дорожки, которые помогают сделать сцену более реалистичной.
Нейросеть для звука видео
При видеомонтаже часто требуется очистить речь, убрать шум, добавить музыку или усилить отдельные эффекты. ИИ-сервисы позволяют автоматизировать значительную часть такой работы. Они могут анализировать аудиодорожку и выполнять обработку без большого количества ручных настроек. Особенно востребованы функции шумоподавления, улучшения разборчивости речи и выравнивания громкости.
Нейросеть для генерации звука для видео
Такие инструменты помогают создавать аудиосопровождение с учётом конкретной видеосцены. С их помощью можно получить звуки окружающей среды, шаги, звуки движения объектов, атмосферные шумы, фоновые эффекты, музыку и голосовое сопровождение. Это даёт дополнительные возможности видеомейкерам, блогерам и разработчикам контента.
Нейросеть для улучшения звука
Иногда создавать новую запись не требуется — достаточно привести в порядок уже существующую. Нейросеть может помочь снизить уровень фонового шума, удалить отдельные помехи, сделать речь более чёткой, улучшить звучание микрофонной записи, выровнять громкость и повысить разборчивость голоса. Такие функции особенно полезны для материалов, записанных в помещениях с плохой акустикой или на смартфон.
Нейросеть для обработки звука
ИИ способен автоматизировать операции, которые раньше требовали ручной работы в аудиоредакторе. Модель может определить речь и шум, разделить компоненты записи и применить подходящую обработку. Во многих сервисах достаточно загрузить файл и выбрать нужный режим. В результате экономится время, а качественный результат становится доступнее людям без глубоких знаний в звукорежиссуре.
Как выбрать нейросеть для работы с аудио
Начинать выбор стоит с конкретной задачи. Для преобразования текста в речь нужен TTS-сервис. Для интервью, лекций и совещаний — инструмент распознавания. Для видеомонтажа и игр — генератор звуковых эффектов. Если необходимо улучшить готовую запись, стоит искать сервис с функциями обработки и шумоподавления. Также при выборе полезно проверить поддержку русского языка, условия бесплатного тарифа, максимальный размер или длительность файла, качество генерации, доступные форматы экспорта, функции работы с голосом, скорость обработки и условия коммерческого использования.
Заключение
Искусственный интеллект постепенно превращает работу со звуком в более быстрый и доступный процесс. Современная нейросеть для аудио способна не только создавать новые записи, но и распознавать речь, переводить её, улучшать качество и автоматически обрабатывать готовые материалы. Бесплатные решения позволяют познакомиться с технологией без покупки профессионального ПО, а генеративные модели дают возможность создавать музыку, голос и звуковые эффекты практически из одного текстового описания. В итоге ИИ можно использовать почти на каждом этапе работы с аудио — от создания исходной дорожки до её обработки, перевода и подготовки финальной версии для видео.

Другие статьи